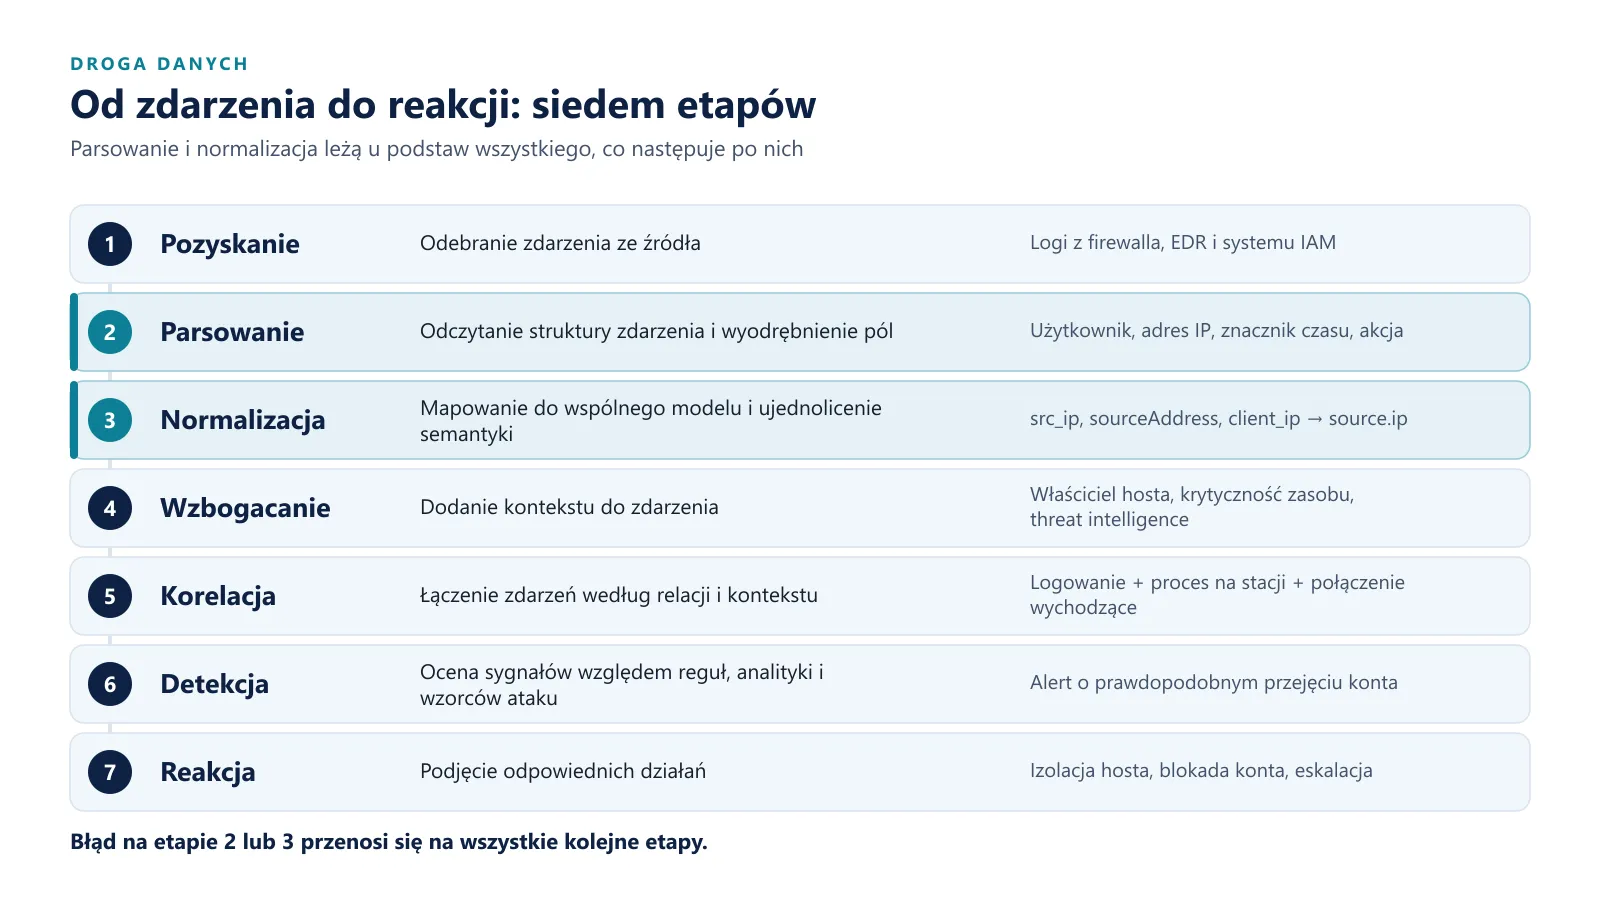
Zebranie logów to dopiero początek. O tym, czy SIEM rozpozna atak, decyduje to, czy potrafi poprawnie odczytać, ujednolicić i powiązać zdarzenia z wielu źródeł. Pokazuję tę drogę krok po kroku, na przykładzie trzech surowych rekordów.
14 października obchodzony jest Światowy Dzień Normalizacji (World Standards Day), promowany przez organizacje normalizacyjne ISO, IEC i ITU. Hasło dotyczy norm i wspólnych standardów w ogóle, ale w pracy zespołu bezpieczeństwa ma bardzo konkretne przełożenie: jeśli każdy system mówi własnym dialektem, nikt nie złoży z ich komunikatów jednego zdania.
Dużo logów to jeszcze nie detekcja
Firewalle, endpointy, serwery, systemy tożsamości, aplikacje i usługi chmurowe generują zdarzenia nieprzerwanie. Każde źródło robi to po swojemu: inny format, inne nazwy pól, inna definicja tego, co jest „zdarzeniem”. Płacimy za przesył i przechowywanie, a pulpit pokazuje rosnący licznik zdarzeń na sekundę. Daje to poczucie widoczności.
Poczucie to bywa pozorne. Widoczność w sensie „mogę wyszukać ciąg znaków” to co innego niż widoczność w sensie „system rozumie, co się stało, komu i w jakiej kolejności”. Ta druga zależy od etapów, o których tu mowa: parsowania, normalizacji, wzbogacania i korelacji.
Skąd pochodzą dane
Typowe źródła różnią się nie tylko formatem, ale też sposobem dostarczania i poziomem szczegółowości:
- Syslog. Zarówno protokół, jak i format. Nowszy RFC 5424 zawiera znacznik czasu ze strefą, starszy zapis BSD (RFC 3164) ma datę w postaci „Oct 14 09:16:41”, bez roku i strefy.
- JSON. Struktura jest czytelna, ale schemat jest dowolny: ten sam adres może nazywać się
src_ip,sourceAddressalboclient.ip. - Windows Event Log. Zdarzenia z identyfikatorami (np. 4624 i 4625 dla udanego i nieudanego logowania), w których znaczenie pól zależy od ID zdarzenia i typu logowania.
- API usług chmurowych. Dane pobiera się cyklicznie, z limitami zapytań, stronicowaniem i opóźnieniem względem zdarzenia.
- Telemetria endpointów. Zwykle bogata, ale w schemacie producenta agenta.
Do tego dochodzi różna szczegółowość: jedno źródło loguje każdą sesję, inne tylko agregaty co kilka minut. Nie da się z tego zbudować spójnego obrazu bez ujednolicenia.
Parsowanie: odczytać, co zostało zapisane
Parser zamienia surowy tekst w strukturę. W praktyce robi pięć rzeczy:
- Rozpoznaje format i źródło, bo ten sam port może dostarczać logi z kilku produktów.
- Wyodrębnia pola: użytkownika, adres, port, akcję, nazwę procesu.
- Nadaje typy: „443” staje się liczbą, adres IP typem adresowym, a nie tekstem.
- Ustala znacznik czasu: format, strefę, rok, rozdzielczość.
- Zachowuje identyfikatory: sesji, procesu, hosta, konta, bez których nie da się zdarzeń powiązać.
Osobny temat to rekordy błędne i niekompletne: ucięte linie, komunikaty wielolinijkowe, pola dodane po aktualizacji oprogramowania źródła. Dobry parser nie gubi ich po cichu, tylko oznacza je jako nierozpoznane, żeby ktoś mógł zareagować.
Jedna uwaga: „poprawnie sparsowane” znaczy tylko tyle, że pola zostały wyodrębnione. Nie znaczy, że dane są kompletne, że zdarzenie dotarło w całości ani że wiemy, co oznacza dane pole.
Normalizacja to nie parsowanie
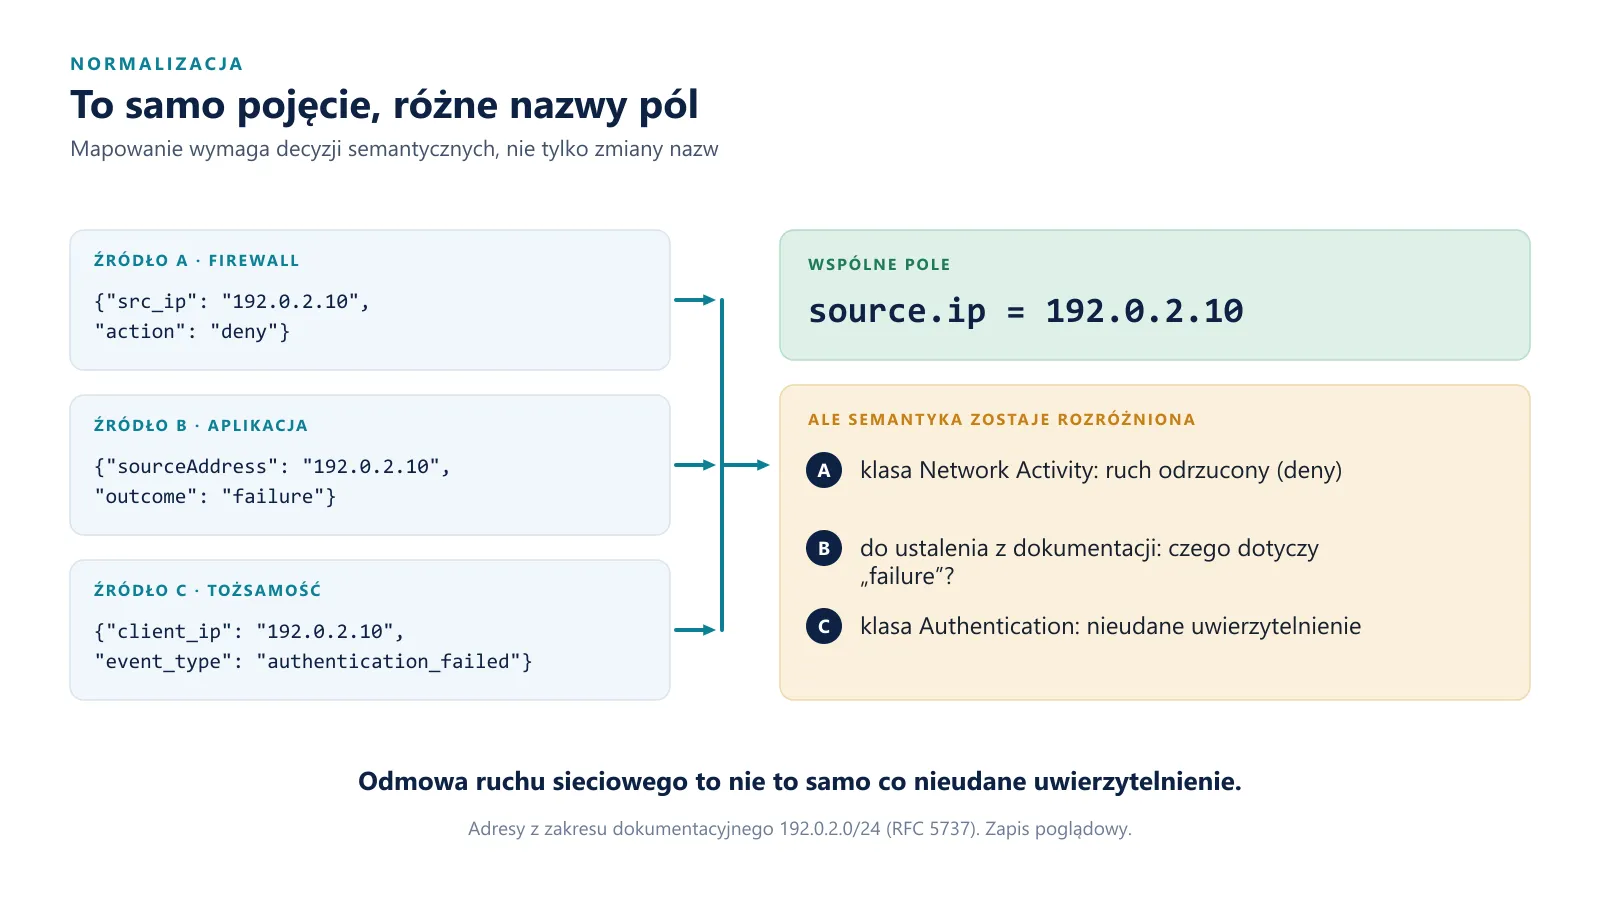
Te dwa pojęcia często się utożsamia, a to dwa różne zadania. Parsowanie odpowiada na pytanie jakie pola są w tym rekordzie. Normalizacja odpowiada na pytanie jakie jest ich znaczenie we wspólnym modelu. Zobaczmy trzy rekordy opisujące to samo pojęcie:
{"src_ip": "192.0.2.10", "action": "deny"}
{"sourceAddress": "192.0.2.10", "outcome": "failure"}
{"client_ip": "192.0.2.10", "event_type": "authentication_failed"}
Po normalizacji wszystkie trzy mają wspólne pole źródłowego adresu IP (np. source.ip), więc jedno zapytanie o 192.0.2.10 obejmie wszystkie źródła. To duża wartość. Ale zanim pola zostaną zmapowane, trzeba ustalić, czy naprawdę oznaczają to samo w kontekście danego produktu. Do tego nadal potrzebne są rozróżnienia semantyczne: odmowa ruchu sieciowego (deny) to nie to samo co nieudane uwierzytelnienie (authentication_failed), a „failure” w drugim rekordzie wymaga sprawdzenia w dokumentacji źródła, czego dokładnie dotyczy.
Praktyczna rada: mapowanie bywa stratne. Pola, które nie mają odpowiednika we wspólnym modelu, warto zachować obok, w oryginalnej postaci, razem z całym surowym rekordem. Pozwala to wrócić do źródła, gdy mapowanie okaże się błędne.
Wzbogacanie i czas
Znormalizowane zdarzenie mówi „co”. Kontekst mówi „czy to ważne”. Wzbogacanie dopisuje do zdarzenia dane z innych systemów: właściciela i krytyczność zasobu z inwentarza, rolę konta z katalogu tożsamości, położenie adresu, informacje z threat intelligence.
Ma to jedną pułapkę: kontekst musi dotyczyć chwili zdarzenia, a nie chwili analizy. Ten sam adres z puli DHCP rano należał do jednej stacji, po południu do innej. Wzbogacenie dzisiejszym stanem inwentarza przypisze zdarzenie nie temu hostowi.
Drugi element to czas. Bez synchronizacji zegarów (NTP), jednoznacznych stref i roku w znaczniku czasu nie da się ułożyć zdarzeń w kolejności. Trzeba też rozróżniać czas zdarzenia od czasu jego odebrania przez SIEM. Przesunięcie o trzy minuty potrafi wyrzucić zdarzenie poza okno korelacji i reguła nigdy się nie uruchomi.
Korelacja: związek, nie zbieżność
Korelacja łączy zdarzenia według relacji i kontekstu. Sam fakt wystąpienia trzech zdarzeń w krótkim czasie nie dowodzi, że dotyczą jednego ataku. Potrzebne są właściwe identyfikatory, oś czasu, relacje między źródłami i ocena kontekstu. Korelacja nie polega też wyłącznie na porównaniu adresów IP.
Błędy w danych wejściowych odbijają się na jej skuteczności w obie strony:
- Więcej false positives: łączenie po samym adresie IP (NAT, DHCP, adresy współdzielone), zbyt szerokie okno czasowe, zdarzenia przypisane do złego hosta przez nieaktualne wzbogacenie.
- Więcej false negatives: ten sam użytkownik zapisany raz jako
CORP\jkowalski, a raz jakojkowalski@firma.pl, czyli dwa różne ciągi znaków; pole niewypełnione; źródło, które przestało wysyłać; opóźniona ingestia poza oknem reguły.
Przykład end-to-end
Prześledźmy trzy surowe rekordy (dane ilustracyjne, adresy z zakresów dokumentacyjnych). Najpierw system tożsamości odnotowuje serię nieudanych logowań użytkownika jkowalski z adresu zewnętrznego (pięć prób między 07:11:40 a 07:12:20 UTC), a potem udane:
{"eventTime":"2026-10-14T09:12:31+02:00","actor":"jkowalski",
 "result":"SUCCESS","ip":"203.0.113.45"}
Półtorej minuty później endpoint zgłasza uruchomienie PowerShella przez edytor dokumentów, a potem firewall rejestruje połączenie wychodzące:
2026-10-14T07:14:02Z host=WS-0142 user=CORP\jkowalski proc=powershell.exe parent=winword.exe

<134>Oct 14 09:16:41 fw01 action=allow src=10.20.1.42 dst=198.51.100.77 dport=443
Trzy źródła, trzy formaty, brak wspólnego klucza na pierwszy rzut oka. Co się dzieje po drodze:
- Parsowanie. Wyodrębniamy pola z JSON-a, z pary klucz=wartość i z syslogu. W rekordzie firewalla nie ma roku ani strefy, więc parser musi je dostać z konfiguracji źródła.
- Normalizacja. Czasy sprowadzamy do UTC (09:12:31+02:00 to 07:12:31Z, a lokalne 09:16:41 z firewalla, przy założeniu strefy CEST, to 07:16:41Z). Nazwę konta sprowadzamy do jednej postaci (
user.name = jkowalski), zdarzeniom nadajemy klasy: uwierzytelnienie, aktywność procesu, aktywność sieciowa. - Wzbogacanie. Z inwentarza i danych DHCP z tej chwili:
10.20.1.42to stacjaWS-0142, używana przezjkowalski. - Korelacja. Wspólnym kluczem nie jest adres IP (tożsamość widzi adres zewnętrzny, firewall wewnętrzny), tylko użytkownik, host i okno około pięciu minut.
- Detekcja. Sekwencja „seria nieudanych logowań, udane logowanie, podejrzany proces, połączenie wychodzące” pasuje do wzorca przejęcia konta i generuje alert.
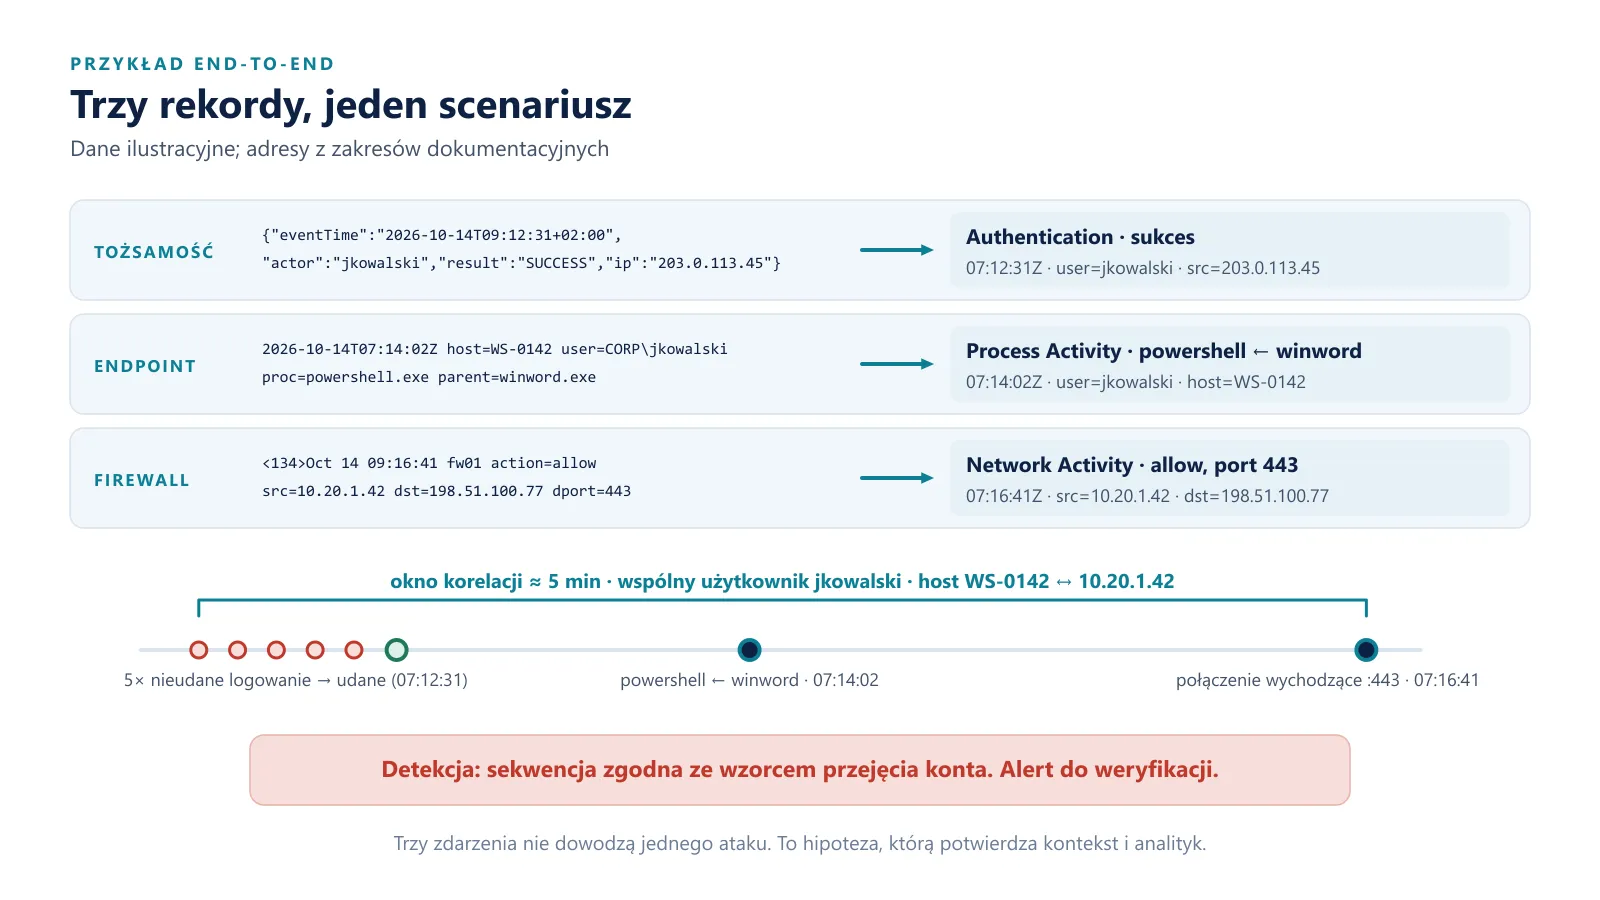
Dwa zastrzeżenia. Po pierwsze, alert to hipoteza, nie wyrok: analityk sprawdzi, czy użytkownik rzeczywiście logował się z tego adresu i czy dokument z makrem był legalny. Po drugie, wystarczy jedno wadliwe ogniwo, żeby cały łańcuch zniknął: niewłaściwa strefa czasowa w firewallu, nazwa konta w innej postaci albo nieaktualny inwentarz.
Jak mierzyć jakość danych
Jakość danych można i trzeba mierzyć, tak samo jak dostępność usług. Kilka wskaźników, które dobrze się sprawdzają jako punkt wyjścia:
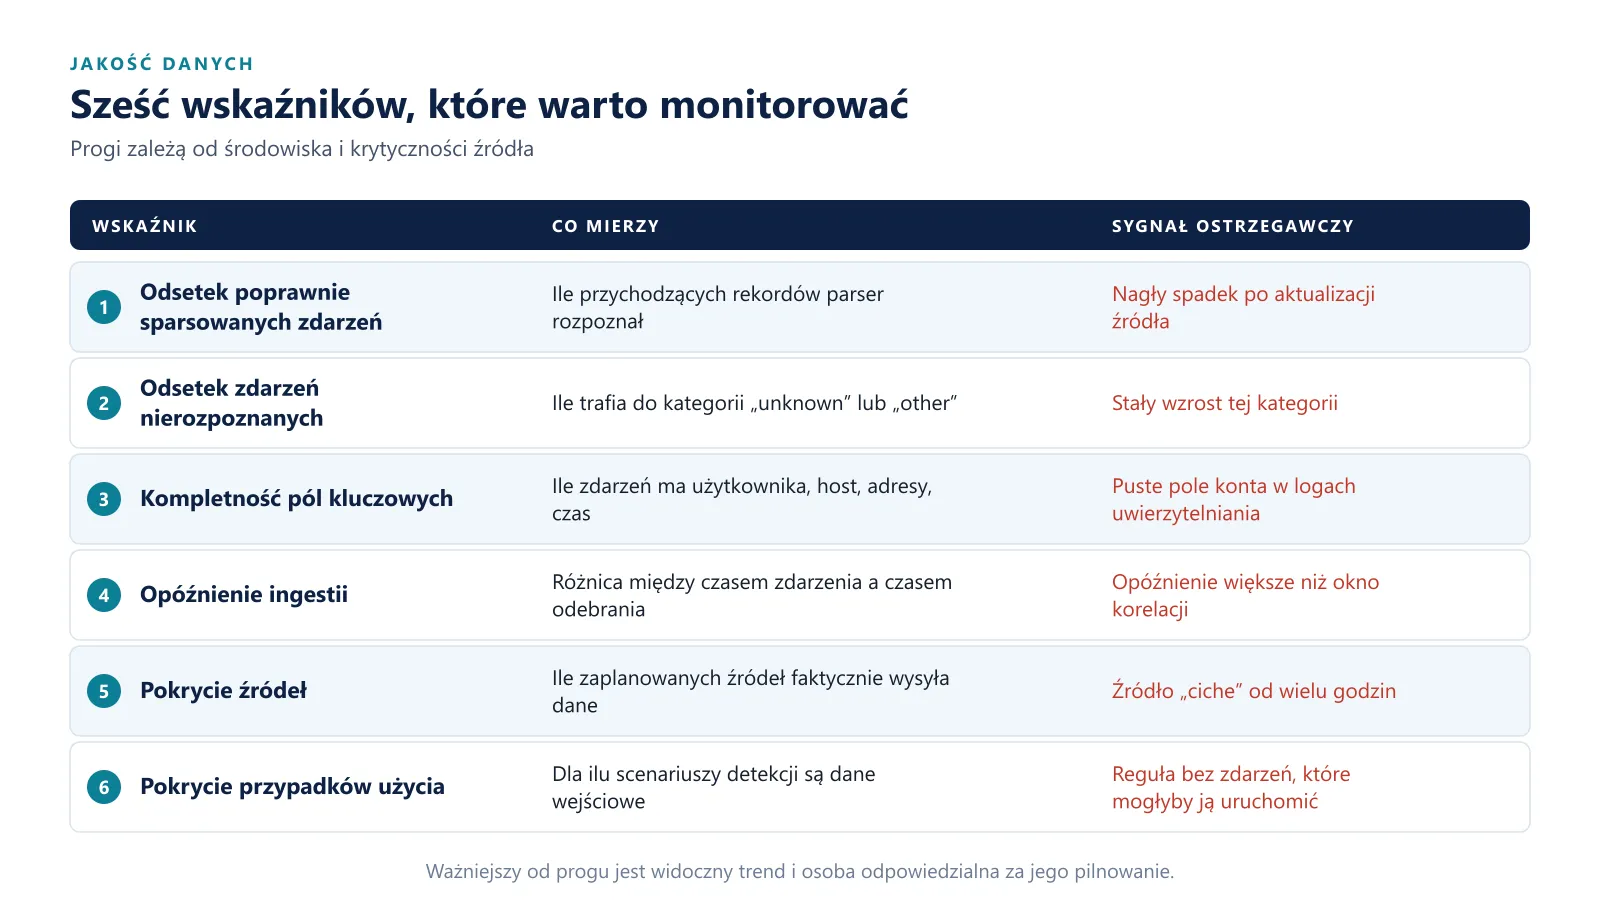
Progów liczbowych nie podaję celowo: zależą od środowiska i krytyczności źródła. Ważniejsze, żeby trend był widoczny i żeby ktoś odpowiadał za jego pilnowanie.
Standardy i modele danych
Warto rozdzielić trzy warstwy, które w rozmowach często się mieszają. Transport to sposób przesyłania (syslog, HTTPS, kolejki komunikatów). Format to zapis zdarzenia (JSON, XML, CEF). Schemat to słownik: nazwy pól, ich typy i klasy zdarzeń. Można przesłać JSON syslogiem i nadal nie mieć wspólnego schematu.
Właśnie lukę schematu wypełniają otwarte modele danych. Jednym z nich jest OCSF (Open Cybersecurity Schema Framework), otwarty projekt dostarczający niezależny od producenta schemat zdarzeń bezpieczeństwa; od listopada 2024 jest projektem Linux Foundation. Nie zależy on od formatu przechowywania ani od metody zbierania danych. Schemat sam niczego jednak nie zmapuje: ktoś nadal musi opisać, jak pola każdego źródła przekładają się na wspólny model. Korzyść jest długofalowa, bo mapowanie wykonuje się raz, a nie osobno dla każdej reguły.
AI i automatyzacja: co pomaga, a czego nie naprawi
Automatyzacja i modele językowe realnie przyspieszają część pracy: proponują szkice parserów i mapowań na podstawie próbek logów, streszczają alerty, pomagają szukać. Nie zastąpią jednak poprawnej interpretacji danych wejściowych.
- Brakującej telemetrii nie da się wywnioskować: jeśli źródło nie wysyła zdarzenia, nic go nie odtworzy.
- Źle zmapowane pole zostanie źle zinterpretowane, tylko szybciej i pewniej. Model rozumuje na tym, co dostał.
- Wygenerowany parser może wyglądać poprawnie i gubić pole w części rekordów, dlatego wymaga walidacji na próbkach rzeczywistych i brzegowych, tak jak parser napisany ręcznie.
Checklista przed wdrożeniem SIEM
- Priorytety źródeł wynikające ze scenariuszy detekcji, a nie z łatwości podłączenia.
- Właściciel danych dla każdego źródła: kto zmienia konfigurację logowania i kto reaguje, gdy format się zmieni.
- Walidacja parserów na próbkach rzeczywistych, w tym uciętych i nietypowych.
- Kontrola zmian: aktualizacja źródła uruchamia test parsera.
- Czas: synchronizacja zegarów i zdefiniowana strefa każdego źródła.
- Inwentarz zasobów i tożsamości jako wiarygodne źródło wzbogacania, z historią zmian.
- Testy detekcji: symulacja scenariusza end-to-end i sprawdzenie, czy alert się pojawia.
- Wskaźniki jakości z poprzedniej sekcji, monitorowane w sposób ciągły.
Podsumowanie
Zbieranie logów to dopiero początek. Wartością jest możliwość poprawnej interpretacji zdarzeń i reakcji na nie, a ta opiera się na rzeczach mało efektownych: parserach, wspólnym schemacie, poprawnym czasie i aktualnym kontekście. Dlatego jakość danych jest równie ważna jak ich ilość.
Źródła
- World Standards Day — ISO, IEC, ITU
- OCSF — Open Cybersecurity Schema Framework
- RFC 5424 — The Syslog Protocol
- RFC 3164 — The BSD Syslog Protocol
- RFC 5737 — adresy IPv4 do dokumentacji
- NIST SP 800-92 — Guide to Computer Security Log Management
- Microsoft — zdarzenie 4625: nieudane logowanie do konta
Artykuł edukacyjny, niezależny od producenta; bez porównań produktów. Rekordy, nazwy użytkowników, hostów i adresy w przykładzie są ilustracją (adresy z zakresów dokumentacyjnych RFC 5737). Klasy zdarzeń w przykładzie nazwano poglądowo, w konwencji zbliżonej do OCSF; nie jest to pełne mapowanie schematu. Informacja o statusie OCSF jako projektu Linux Foundation pochodzi ze strony projektu (stan na 14.10.2026). Okno korelacji ok. 5 minut jest wartością przykładową.