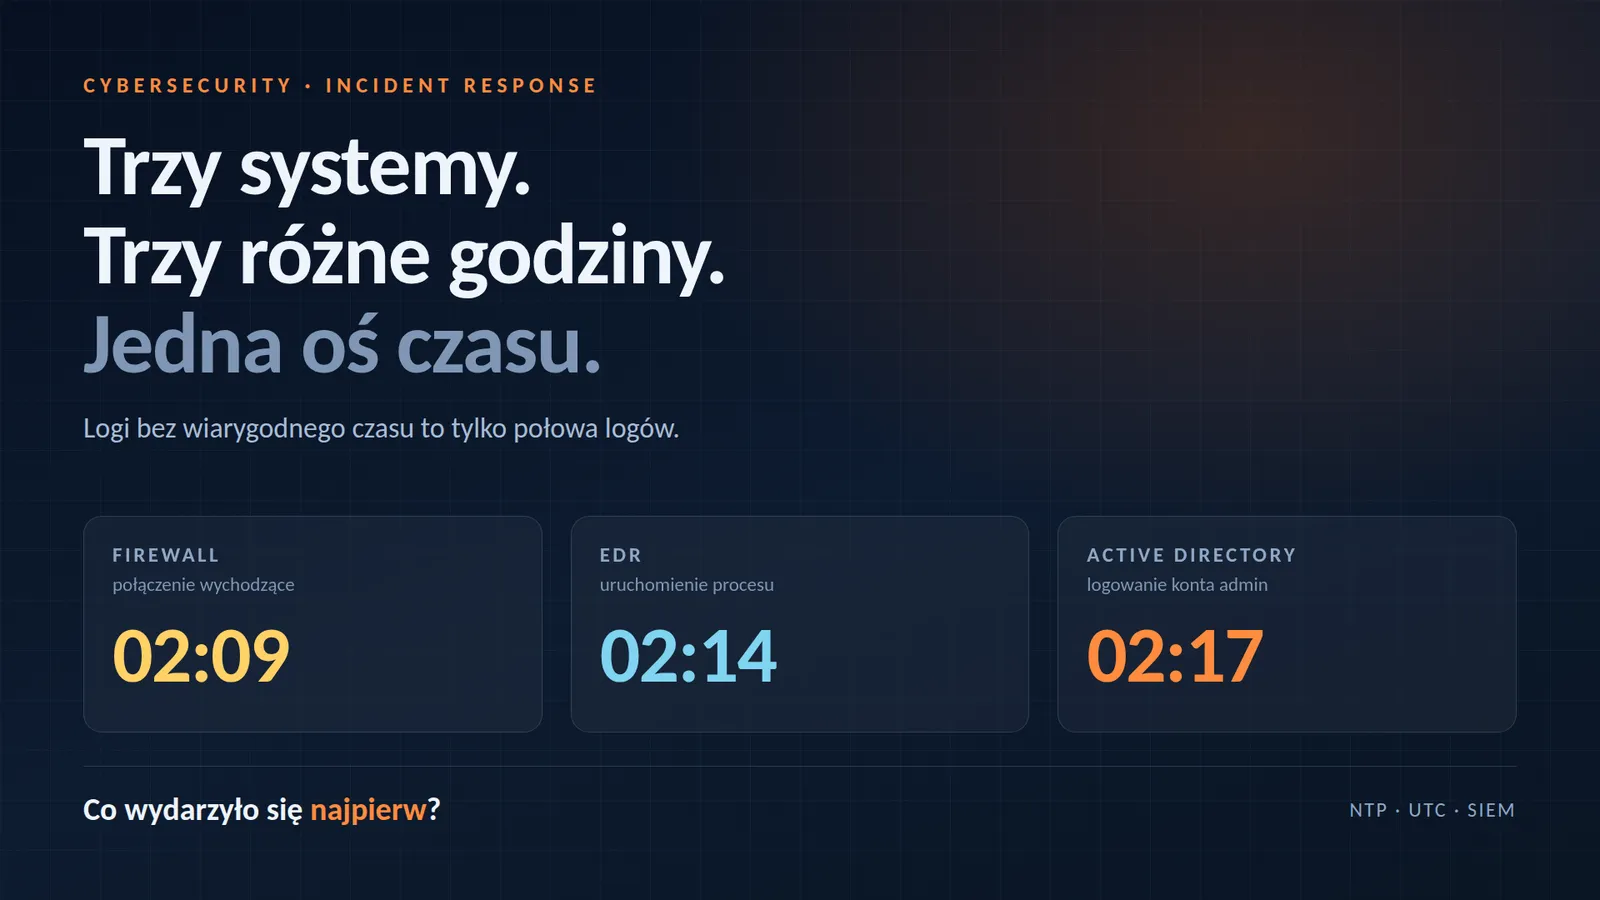
Synchronizacja czasu jest tym elementem infrastruktury, o którym nikt nie myśli, dopóki nie trzeba odtworzyć przebiegu incydentu. Wtedy okazuje się, że każde źródło logów ma własną wersję tego, która była godzina. Poniedziałek rano — SOC analizuje podejrzaną aktywność na jednym z serwerów.
- EDR pokazuje uruchomienie nietypowego procesu o 02:14.
- Firewall rejestruje połączenie z zewnętrznym adresem IP o 02:09.
- Active Directory widzi logowanie konta uprzywilejowanego o 02:17.
- SIEM pokazuje jeszcze inną kolejność zdarzeń.
Dane są. Logi są. Alerty też. Problem w tym, że każdy system ma trochę inną wersję tego, która właściwie była godzina.
I nagle proste pytanie — co wydarzyło się pierwsze? — przestaje być proste. Czy najpierw nastąpiło logowanie? Czy proces został uruchomiony przed połączeniem z Internetem? Czy komunikacja sieciowa była początkiem incydentu, czy już jego skutkiem? Czy mamy jeden łańcuch zdarzeń, czy kilka niezależnych aktywności?
Dlaczego czas w logach jest materiałem dowodowym
Przy normalnej pracy kilka minut różnicy może pozostać niezauważone przez miesiące. System działa, użytkownicy się logują, backup się wykonuje, firewall przepuszcza ruch, logi trafiają do SIEM. Wszystko wygląda dobrze — do momentu, w którym trzeba odtworzyć przebieg incydentu.
W analizie bezpieczeństwa budujemy jedną oś czasu z kilkunastu niezależnych źródeł: firewalli, endpointów, AD, serwerów, aplikacji, VPN, chmury, IDS/IPS, EDR/XDR. Jeżeli każde z nich rozumie „teraz” inaczej, korelacja zaczyna się rozsypywać. Możemy mieć kompletne logi i jednocześnie wyciągnąć z nich błędne wnioski o kolejności zdarzeń.
Synchronizacja czasu to nie kosmetyka konfiguracji. To warstwa fundamentowa incident response i digital forensics — i dlatego znajdziecie ją wprost w ISO/IEC 27001:2022 (Annex A 8.17 Clock synchronisation) oraz w PCI DSS 4.0 (wymaganie 10.6).
Jaka rozbieżność czasu jest dopuszczalna?
Nie ma jednej liczby — bo różne warstwy mają różne progi bólu. I to jest najczęstsze źródło fałszywego poczucia bezpieczeństwa.
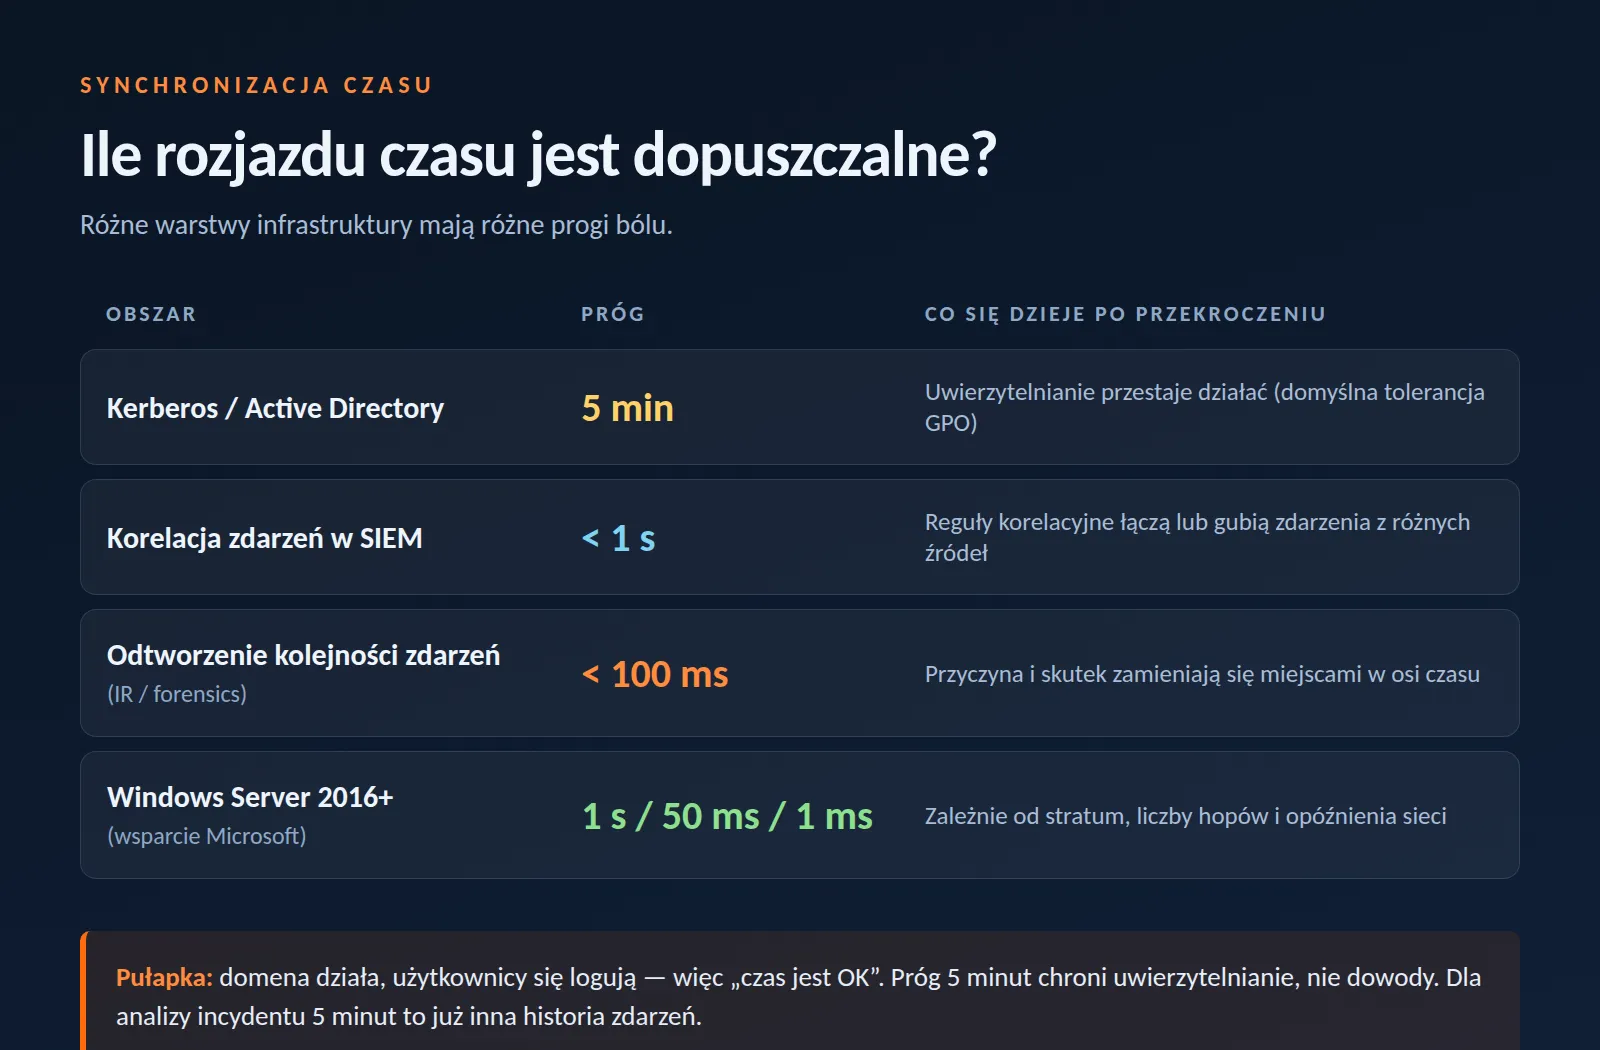
- Kerberos / Active Directory — 5 minut. Domyślna wartość polityki Maximum tolerance for computer clock synchronization. Po przekroczeniu uwierzytelnianie po prostu przestaje działać i problem sam się zgłasza.
- Korelacja w SIEM — poniżej 1 sekundy. Reguły oparte na oknach czasowych zaczynają łączyć zdarzenia, które nie mają ze sobą nic wspólnego, albo rozrywać te, które mają.
- Odtworzenie kolejności zdarzeń — poniżej 100 ms. To realny cel w sieci LAN i dopiero on daje pewność, co było przyczyną, a co skutkiem.
- Windows Server 2016 i nowsze — 1 s, 50 ms lub 1 ms. Microsoft wspiera te poziomy warunkowo: zależnie od stratum źródła, liczby przeskoków sieciowych, opóźnienia i obciążenia CPU.
Jaki jest dryf zegara w PC w skali roku?
Zegar komputera to zwykły oscylator kwarcowy, typowo o dokładności ±20–50 ppm. W praktyce oznacza to:
- ~12 ppm — to mniej więcej 1 sekunda na dobę
- 2–4 s / dobę — typowy dryf niesynchronizowanego PC
- 10–30 min / rok — gdzie realnie ląduje zegar bez NTP
Do tego dochodzą czynniki, które przesuwają dryf w locie: temperatura (sam start maszyny i nagrzanie obudowy potrafi zmienić błąd częstotliwości o kilkanaście ppm), wirtualizacja (kradzież cykli CPU, snapshoty, migracje na żywo) oraz urządzenia bez podtrzymania RTC, które po restarcie startują od epoki — i wtedy w SIEM pojawia się log z 1 stycznia 1970.
Kluczowy wniosek: rozjazd nie jest zdarzeniem. To proces ciągły. Urządzenie zsynchronizowane raz, przy wdrożeniu, po dwóch latach potrafi być pół godziny obok.
Jak często powinna działać synchronizacja NTP?
Odpowiedź praktyczna: ciągle, w oknie 64–1024 sekund — i to nie jest wymysł, tylko domyślne zachowanie standardowych implementacji. Zarówno chrony, jak i usługa w32time mają domyślnie minpoll 6 (64 s) i maxpoll 10 (1024 s, czyli ~17 minut) i same dobierają interwał w tym zakresie.
Dlaczego to wystarcza? Przy dryfie 20 ppm w ciągu 1024 sekund zegar ucieka o około 20 milisekund — czyli grubo poniżej progu potrzebnego do wiarygodnej osi czasu. Dodatkowo RFC 8633 zaleca, żeby interwał odpytywania nigdy nie przekraczał 24 godzin — inaczej urządzenie przegapi powiadomienie o sekundzie przestępnej.
Jak poprawnie wdrożyć NTP w środowisku firmowym
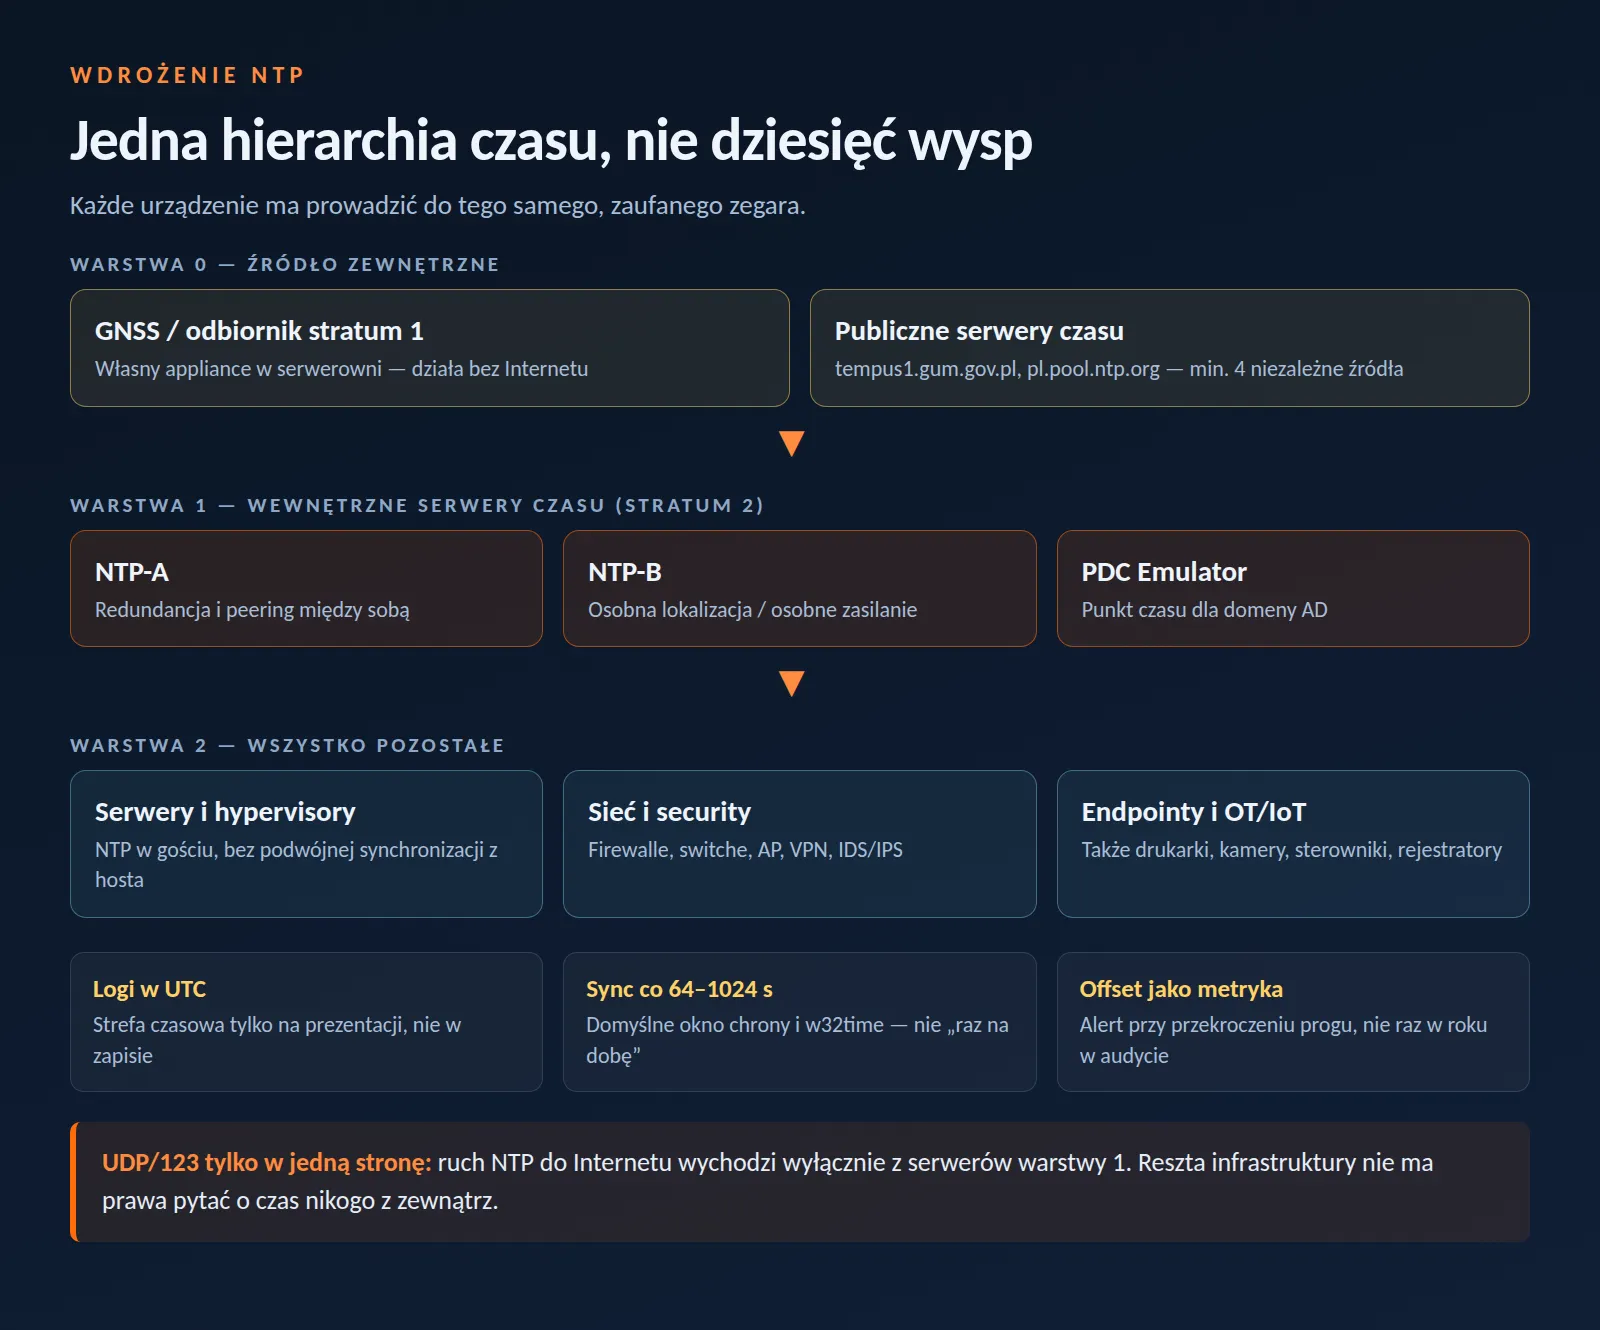
- Zbuduj hierarchię, nie zbiór wysp. Dwa wewnętrzne serwery czasu (stratum 2), które peerują się ze sobą i stanowią jedyny punkt czasu dla całej infrastruktury.
- Co najmniej cztery niezależne źródła zewnętrzne. RFC 8633 mówi wprost: przy jednym źródle każdy jego błąd przenosi się wprost do Ciebie, przy dwóch nie wiadomo, które kłamie, trzy tolerują jedną awarię i degradują się do dwóch. Dla Polski:
tempus1.gum.gov.plitempus2.gum.gov.pl(czas urzędowy GUM) pluspl.pool.ntp.org. - Rozważ własne źródło GNSS. Odbiornik stratum 1 w serwerowni kosztuje mniej niż jedna godzina pracy zespołu IR i utrzymuje czas nawet po odcięciu od Internetu — krytyczne w środowiskach OT i w segmentach izolowanych.
- Zamknij UDP/123 na brzegu. Ruch NTP do Internetu ma wychodzić wyłącznie z wewnętrznych serwerów czasu. Reszta infrastruktury nie ma prawa pytać nikogo z zewnątrz — inaczej dostaniesz dziesięć równoległych źródeł prawdy.
- W domenie AD nie mieszaj mechanizmów. Emulator PDC jest jedynym punktem wejścia czasu do domeny i to on odpytuje serwery wewnętrzne; reszta hostów zostaje przy
NT5DS. - Wybierz jedno źródło dla maszyn wirtualnych. Jednoczesna synchronizacja z hypervisora (VMware Tools, Hyper-V Time Synchronization) i z NTP w gościu to klasyczna przyczyna oscylacji zegara.
- Loguj w UTC. Strefa czasowa to warstwa prezentacji, nie zapisu. Znacznik w formacie ISO 8601 z jawnym offsetem oszczędza kilka godzin przy każdej analizie — i ratuje przed nocą zmiany czasu, w której godzina albo znika, albo powtarza się dwa razy.
- Uwierzytelniaj czas. NTS albo klucze symetryczne z
AES-128-CMAC. RFC 8633 wprost odradza Autokey i MD5. Niezabezpieczony NTP jest podatny na manipulację — a przesunięcie czasu to skuteczny sposób na unieważnienie logów jako dowodu. - Monitoruj offset jako metrykę, nie jako pole w checkliście.
chronyc tracking,w32tm /query /status, SNMP z urządzeń sieciowych — do systemu monitoringu, z progiem ostrzegawczym (np. 100 ms) i krytycznym (1 s). Bez tego „skonfigurowane” nigdy nie zamieni się w „zsynchronizowane”.
Pięć błędów, które najczęściej psują synchronizację czasu w sieci
- Urządzenia zostawione z fabrycznym źródłem czasu producenta — każdy vendor ze swoją pulą, czyli kilka niezależnych hierarchii w jednej sieci.
- Firewall blokujący UDP/123 z VLAN-u OT lub gościnnego — urządzenia po cichu nie synchronizują się i nikt tego nie widzi.
- Logi zapisywane w czasie lokalnym bez offsetu — po eksporcie do SIEM nie da się ich już jednoznacznie ułożyć.
- Brak zapisu czasu do zegara sprzętowego — po restarcie urządzenie startuje z datą sprzed dekad, zanim zdąży odpytać serwer.
- Zegar sprawdzany wyłącznie podczas audytu, raz w roku — czyli w praktyce nie sprawdzany wcale.
Jak sprawdzić synchronizację czasu w pięć minut
Cyberodporność to nie tylko powstrzymanie ataku. To także zdolność udowodnienia, co się wydarzyło, kiedy i w jakiej kolejności.
Jeśli chcecie w pięć minut sprawdzić, jak z tym u siebie stoicie, zadajcie sobie jedno pytanie: ile w tej chwili wynosi offset każdego źródła logów podpiętego do Waszego SIEM-u? Jeżeli odpowiedź brzmi „nie wiem” albo „musiałbym sprawdzić urządzenie po urządzeniu” — to właśnie jest odpowiedź.
Bo podczas incydentu pytanie nie brzmi tylko: co się wydarzyło? Równie ważne jest: co wydarzyło się najpierw?