Rozmowy o ochronie stacji końcowych bardzo szybko schodzą na detekcję: ile alertów, jak są priorytetyzowane, jak wygląda konsola. To zrozumiałe — detekcja jest widoczna. Prewencja jest z definicji niewidoczna: jeśli zadziała, nie ma czego oglądać.
Ta niewidoczność ma jednak konkretną cenę operacyjną, tylko z odwrotnym znakiem. Każda technika zatrzymana przed uruchomieniem to jedna sprawa mniej do przeanalizowania — i jedno mniej pytanie „czy na pewno wszystko posprzątaliśmy”. W tej części cyklu rozkładam na czynniki pierwsze to, co w Sophos Endpoint dzieje się zanim padnie pierwszy alert.
1. Dwa modele obrony i jedna praktyczna różnica
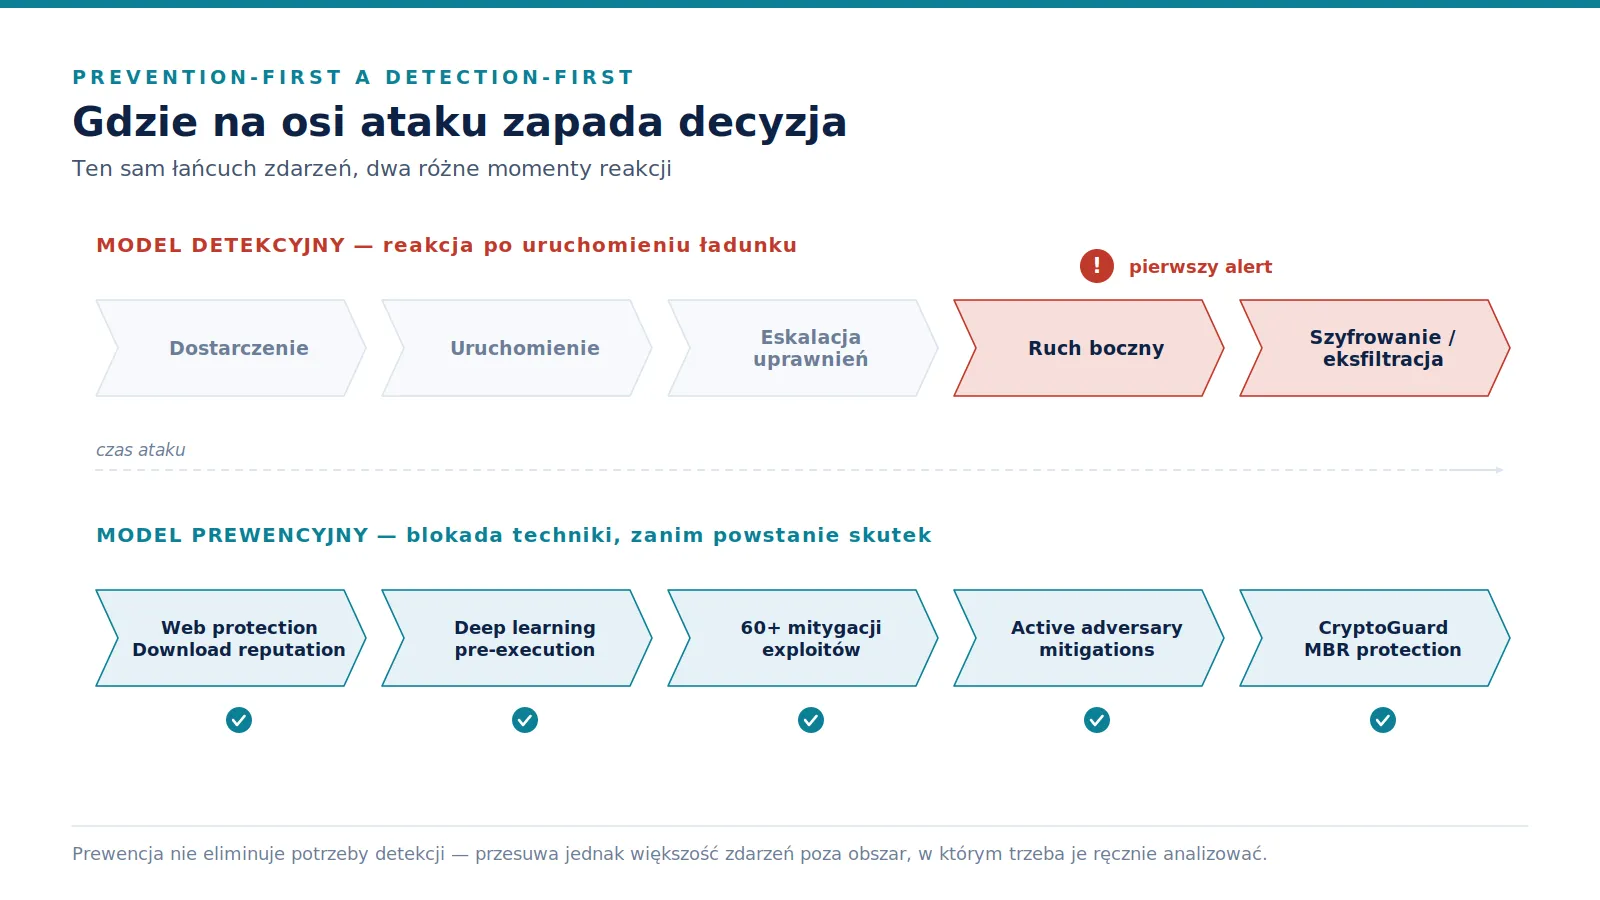
Uproszczony podział wygląda tak. Model detection-first zakłada, że zagrożenie i tak się uruchomi, więc kluczowa jest telemetria: zbieramy zdarzenia, korelujemy je, wykrywamy wzorzec i reagujemy. Model prevention-first zakłada, że im wcześniej przerwiemy łańcuch, tym mniej zostanie do zrobienia później.
W praktyce żaden produkt nie jest wyłącznie jednym albo drugim. Różnica polega na tym, gdzie przesunięty jest środek ciężkości — i ile ochrony faktycznie działa w domyślnej konfiguracji.
Warto też uczciwie powiedzieć, dlaczego ten spór ożył. Narzędzia oparte na modelach językowych obniżyły próg wejścia do tworzenia exploitów i skróciły dystans między odkryciem podatności a jej praktycznym wykorzystaniem. Kiedy czas od pierwszego dostępu do skutku liczy się w minutach, model, w którym alert pojawia się po uruchomieniu ładunku, zostawia coraz węższe okno na reakcję.
2. Zanim plik się uruchomi
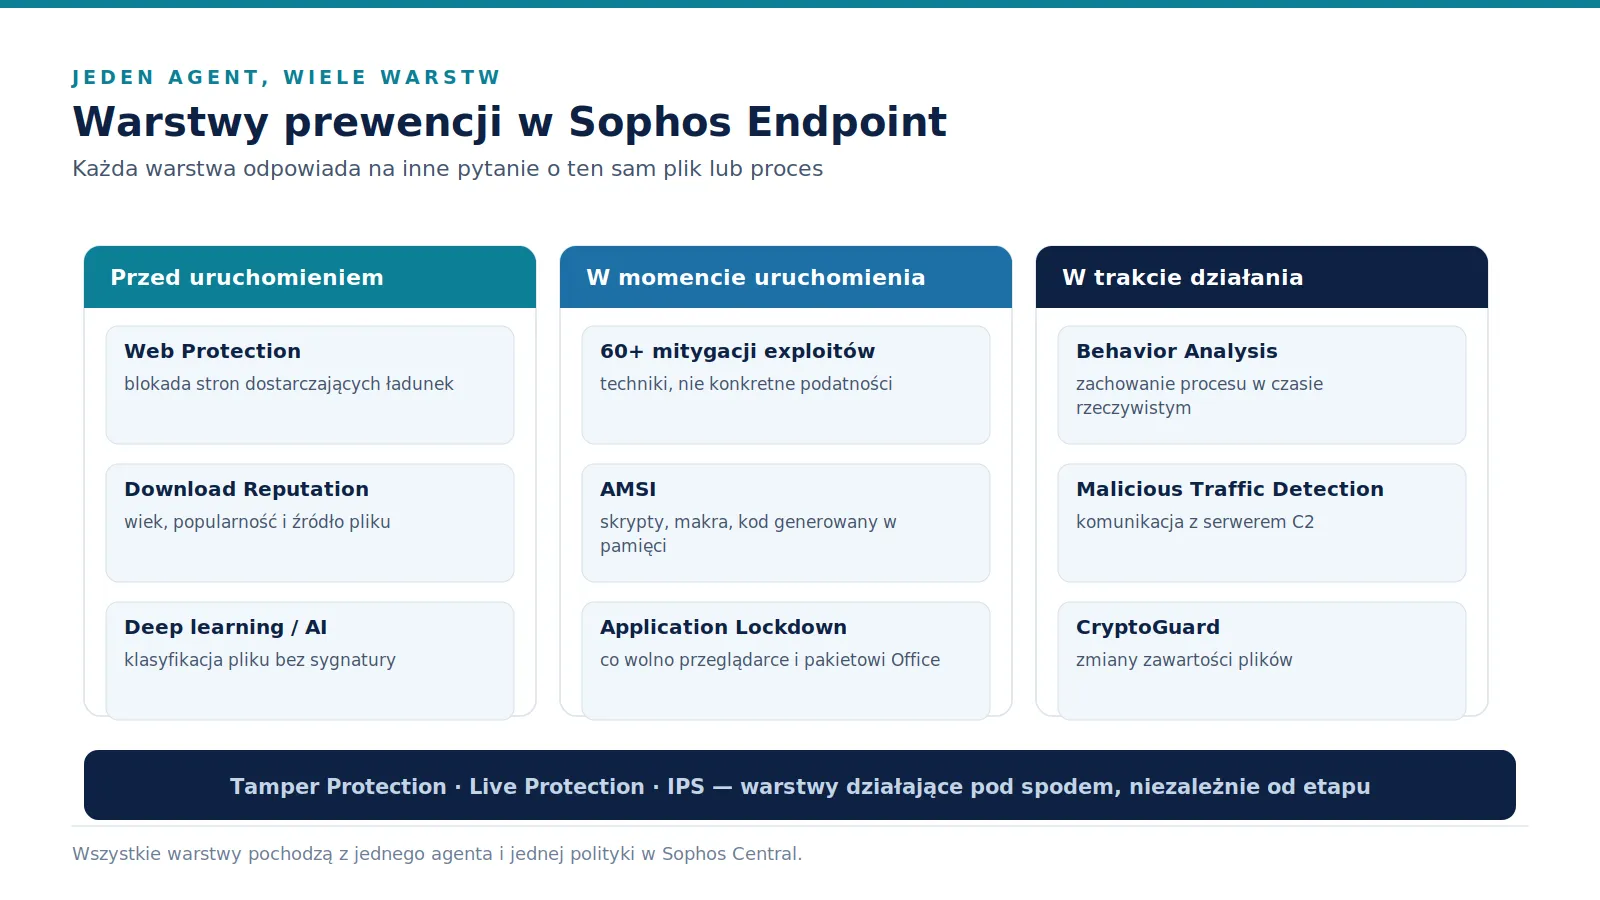
Pierwsza warstwa działa jeszcze przed wykonaniem czegokolwiek. Składają się na nią trzy różne mechanizmy, które odpowiadają na trzy różne pytania.
Web Protection ocenia adres, do którego zmierza przeglądarka lub inny proces. Blokada na tym etapie zatrzymuje zagrożenie na poziomie dostarczenia — użytkownik nie trafia na stronę serwującą ładunek ani na stronę phishingową. Istotny szczegół: mechanizm działa na urządzeniu, więc obowiązuje także wtedy, gdy laptop jest w domu, w hotelu albo w sieci klienta, gdzie firewall organizacji nie sięga.
Download Reputation odpowiada na pytanie o sam plik: jak długo istnieje, jak często występuje, skąd pochodzi. Plik pobrany kilkanaście minut po opublikowaniu, z domeny bez historii, dostaje inny werdykt niż popularny instalator znany od lat.
Modele uczenia głębokiego klasyfikują plik na podstawie jego właściwości, bez sygnatury. To jest warstwa, która ma sens wobec wariantów generowanych masowo — w tym wariantów mutowanych automatycznie, dla których pojęcie „znanej próbki” przestaje być użyteczne. Osobne modele obejmują dokumenty pakietu Office i pliki PDF, czyli najczęstszą powierzchnię dostarczania w kampaniach z załącznikiem.
3. Anti-exploitation: celem jest technika, nie podatność
To najciekawsza — i najczęściej pomijana — część rozmowy o ochronie stacji.
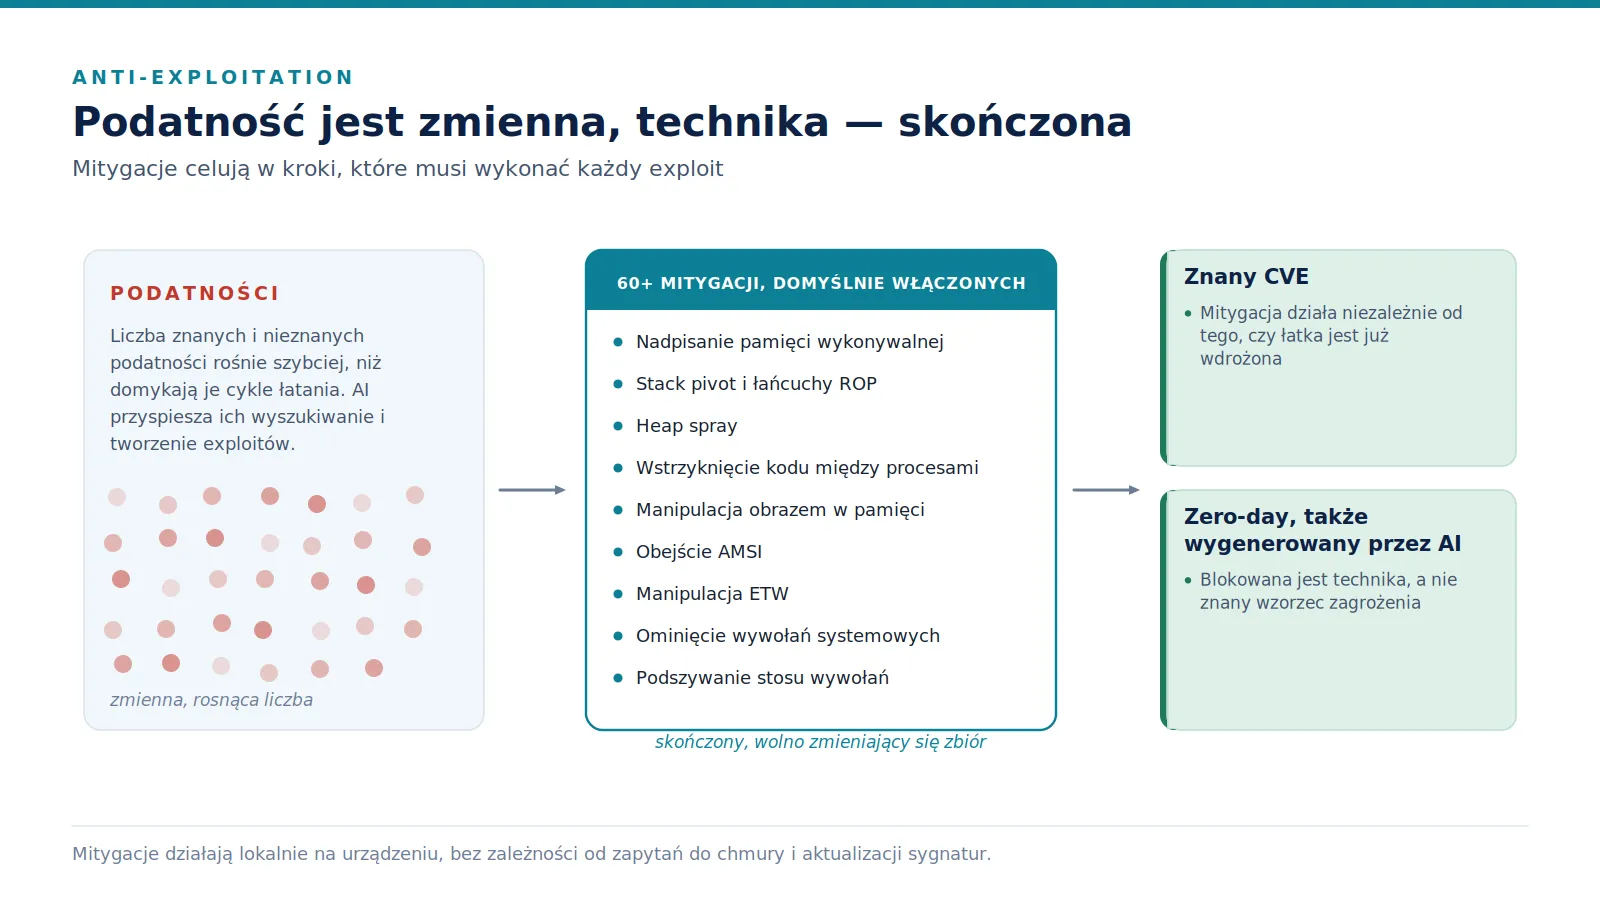
Podatności są zmienne i jest ich coraz więcej. Nie da się ich wszystkich załatać na czas, a raporty o aktywnych napastnikach regularnie pokazują, że między publikacją poprawki a obserwowanym wykorzystaniem podatności potrafi minąć wiele miesięcy. Gdyby ochrona polegała na znajomości konkretnych CVE, przegrywałaby z definicji.
Tyle że zbiór technik, którymi da się zamienić podatność w kompromitację, jest znacznie mniejszy i zmienia się znacznie wolniej. Nadpisanie pamięci tak, by stała się wykonywalna. Przejęcie stosu wywołań i zbudowanie łańcucha ROP. Rozpylenie sterty. Wstrzyknięcie kodu do innego procesu. Manipulacja obrazem modułu w pamięci. Obejście AMSI albo mechanizmu ETW. Ominięcie normalnej ścieżki wywołań systemowych.
Sophos Endpoint stosuje ponad 60 własnych mitygacji celujących właśnie w te kroki. Trzy cechy tego rozwiązania są ważniejsze niż sama liczba:
- Działają domyślnie na każdym chronionym procesie, a nie po zbudowaniu polityki dla wybranych aplikacji.
- Nie wymagają zapytań do chmury ani aktualizacji sygnatur — decyzja zapada lokalnie, w czasie rzeczywistym.
- Są niezależne od tego, czy podatność jest znana. Mitygacja reaguje na próbę wykonania techniki, więc świeżo wygenerowany exploit wygląda dla niej tak samo jak exploit sprzed dwóch lat.
Osobna grupa mitygacji dotyczy etapu po udanej eksploatacji: kradzieży poświadczeń, podnoszenia uprawnień i budowania trwałości. To ten sam pomysł zastosowany dalej w łańcuchu.
4. Kiedy złośliwy jest kontekst, a nie plik
Duża część współczesnych ataków nie zostawia pliku, który dałoby się sensownie sklasyfikować. Kod przychodzi jako skrypt, makro albo ciąg poleceń zbudowany w pamięci.
AMSI — interfejs systemu Windows do skanowania skryptów — pozwala ocenić zawartość, którą interpreter faktycznie wykonuje, także wtedy, gdy była zaciemniona albo powstała w trakcie działania. Warto dodać, że sam AMSI bywa celem: obejście tego mechanizmu jest jedną z technik objętych mitygacjami opisanymi wyżej.
Application Lockdown podchodzi do tematu inaczej. Zamiast pytać, czy kod jest złośliwy, pyta, czy dana aplikacja ma prawo zrobić to, co właśnie robi. Przeglądarka uruchamiająca PowerShell albo dokument tekstowy startujący interpreter to zachowania, które nie są nielegalne technicznie, ale w normalnej pracy nie występują. Ograniczenie ich zamyka dużą klasę scenariuszy bez potrzeby rozpoznawania konkretnego narzędzia.
5. W trakcie działania procesu
Trzecia grupa mechanizmów działa już po uruchomieniu, ale wciąż przed skutkiem.
- Behavior Analysis ocenia sekwencję działań procesu, a nie pojedyncze zdarzenie. Tu wychodzą rzeczy, które w statycznej analizie wyglądają neutralnie.
- Malicious Traffic Detection obserwuje ruch generowany przez procesy inne niż przeglądarka i sprawdza, czy urządzenie nie próbuje rozmawiać z infrastrukturą sterującą atakiem.
- Live Protection uzupełnia decyzję lokalną o zapytanie do bazy wiedzy producenta — zarówno po to, by potwierdzić zagrożenie, jak i po to, by ograniczyć fałszywe alarmy.
- Tamper Protection chroni sam agent. To warstwa, do której wrócę w części drugiej, bo wyłączenie ochrony jest w praktyce jednym z ostatnich kroków przed uruchomieniem ransomware.
Każda z tych warstw zadaje inne pytanie o ten sam proces. Dlatego zagrożenie, które przejdzie obok jednej, ma szansę zatrzymać się na kolejnej — i dlatego nie ma sensu oceniać ochrony po jednym, choćby najlepszym mechanizmie.
6. Ustawienia domyślne jako element architektury
Jest w tej układance element, który brzmi mało efektownie, a w praktyce decyduje o wyniku: co jest włączone w dniu wdrożenia.
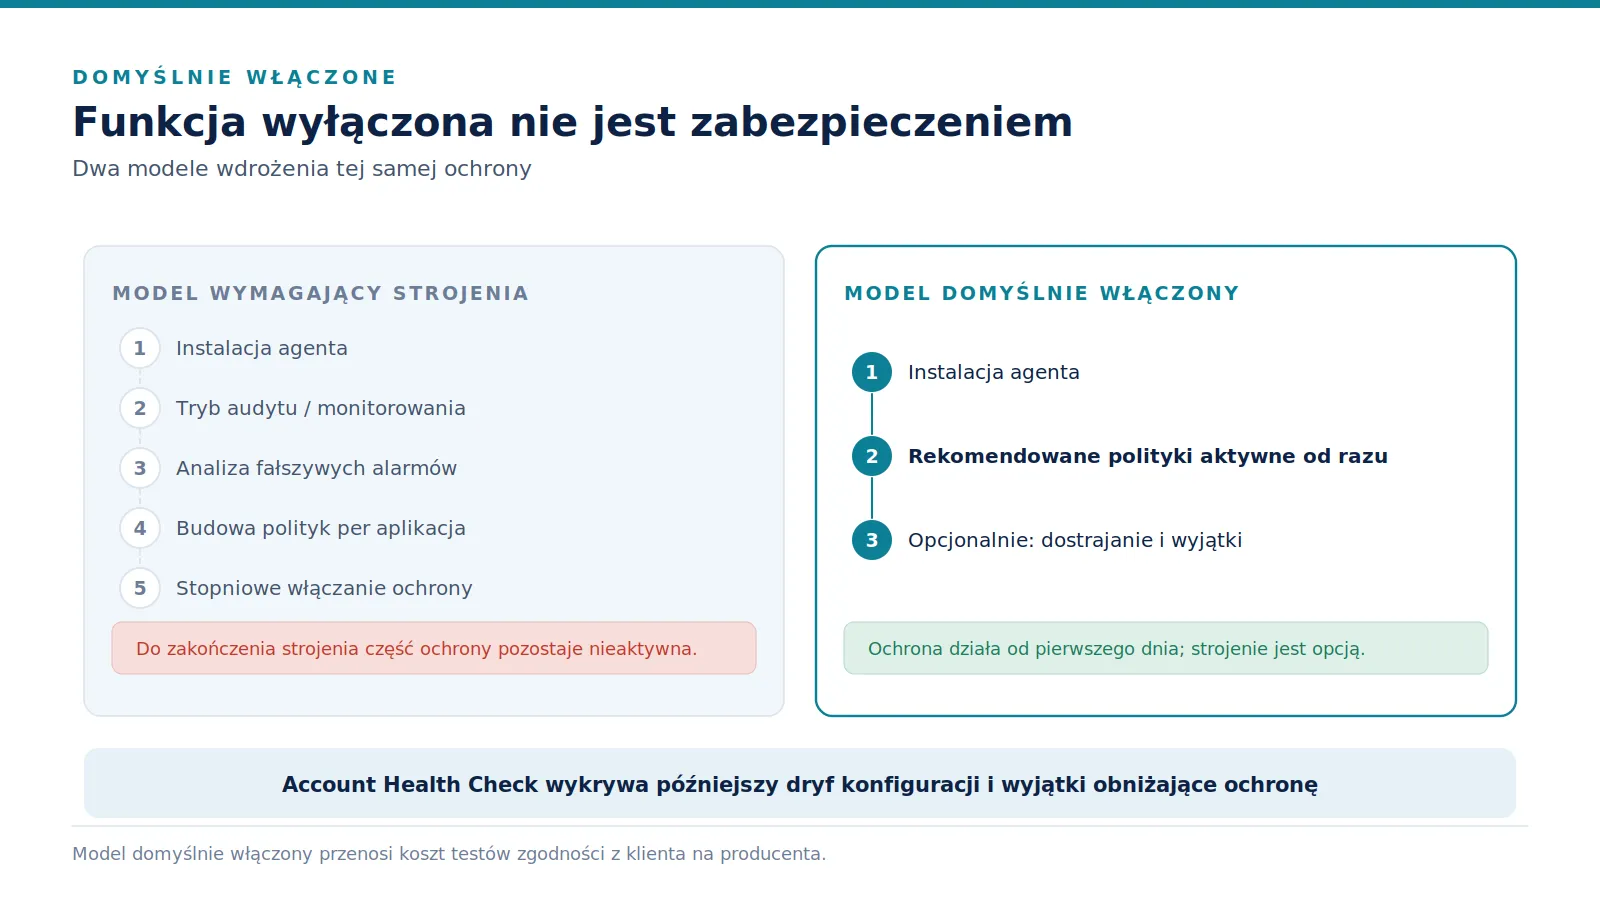
Znany schemat wygląda tak: agent trafia na stacje, ochrona startuje w trybie monitorowania, zespół analizuje fałszywe alarmy, buduje polityki dla poszczególnych aplikacji i stopniowo włącza kolejne funkcje. Kłopot polega na tym, że ten proces często nie ma końca — a do jego zakończenia część ochrony po prostu nie działa.
Podejście przyjęte w Sophos Endpoint jest odwrotne: rekomendowane technologie ochrony są aktywne od instalacji, a strojenie i wyjątki pozostają opcją dla zespołów, które ich potrzebują. To przesunięcie kosztu — testy zgodności z ogromną liczbą aplikacji wykonuje producent, a nie każdy klient osobno.
Druga strona tej samej monety to dryf konfiguracji. Wyjątek dodany „na chwilę”, funkcja wyłączona na czas migracji, osobna polityka dla nowego zespołu — po roku obraz potrafi się istotnie różnić od dokumentacji. Do wykrywania takich odchyleń służy Account Health Check, o którym więcej w części czwartej.
7. Jeden agent, trzy systemy — i koszt tego wszystkiego
Kwestia, która w rozmowach technicznych pojawia się natychmiast po wyliczeniu warstw: ile to kosztuje wydajnościowo. To uzasadniona obawa — wielowarstwowa ochrona historycznie oznaczała zauważalne obciążenie stacji, a każde takie obciążenie kończy się prośbą o wyjątek.
Dwie rzeczy warto tu rozdzielić. Pierwsza to zakres pokrycia: ten sam agent obsługuje Windows, macOS i Linux, zarówno stacje robocze, jak i serwery oraz obciążenia w chmurze. Dla środowisk mieszanych to różnica między jednym zestawem polityk a trzema osobnymi produktami z trzema konsolami — i różnica w tym, czy dane telemetryczne da się w ogóle zestawić ze sobą.
Druga to rzeczywisty narzut. Producent deklaruje w ostatnich wersjach agenta redukcję zużycia pamięci rzędu 40% i utrzymanie obciążenia procesora poniżej 1% w typowej pracy, po przebudowie sposobu przechowywania reguł ochrony i przesyłania danych telemetrycznych. To deklaracja producenta, więc traktowałbym ją jak każdą inną: jako punkt wyjścia do testu na własnym obrazie systemu, nie jako fakt do przyjęcia na słowo.
Praktyczna rada z wdrożeń: pomiar wykonuje się przed wdrożeniem i po nim, na tej samej grupie urządzeń, a nie na podstawie wrażeń użytkowników. Wrażenie „komputer zwolnił po instalacji antywirusa” jest jedną z najbardziej odpornych na dowody opinii w IT, więc lepiej mieć liczby, zanim rozmowa się zacznie.
8. Czego prewencja nie załatwia
Uczciwe zamknięcie tematu wymaga wskazania granic.
Prewencja nie zwalnia z łatania systemów. Mitygacja blokująca technikę kupuje czas, ale nie usuwa podatności — a jeśli urządzenie od pół roku nie dostało aktualizacji, problemem jest coś więcej niż pojedynczy exploit.
Prewencja nie zastępuje widoczności. Zablokowane zdarzenie też jest informacją: skąd przyszło, czy dotyczy jednego hosta, czy dziesięciu, czy poprzedziło je coś jeszcze. To już jest praca dla EDR — temat piątej części.
I wreszcie: prewencja nie zastępuje kopii zapasowych, segmentacji i procesu reakcji na incydent. Zmniejsza prawdopodobieństwo, że będą potrzebne. Nie zmniejsza konsekwencji tego, że ich nie ma.
Źródła
- Sophos — Endpoint Protection (strona produktowa)
- Sophos Central — dokumentacja administratora
- Sophos — Endpoint Security Buyer’s Guide
- Sophos Active Adversary Report — okno między poprawką a wykorzystaniem podatności
- Sophos X-Ops — badania nad zagrożeniami
Podstawą merytoryczną są publiczne materiały produktowe Sophos (solution brief, solution brochure, buyer’s guide) oraz dokumentacja Sophos Central. Informacje zależne od wersji agenta, poziomu licencji i konfiguracji wymagają ponownej weryfikacji przed publikacją.