Dotychczasowe części cyklu dotyczyły sytuacji, w której coś zostaje zatrzymane. Ta dotyczy sytuacji odwrotnej: na urządzeniu jest ktoś, kto działa ręcznie. Nie automat, nie skrypt, tylko operator, który reaguje na to, co widzi, i szuka drogi dalej.
To jakościowo inny problem. Automat da się przewidzieć. Człowiek — albo agent działający w podobny sposób — dostosuje się do napotkanej przeszkody. Odpowiedzią na to jest warstwa, która sama zmienia swoje zachowanie w zależności od kontekstu.
1. Trzy poziomy, trzy zakresy
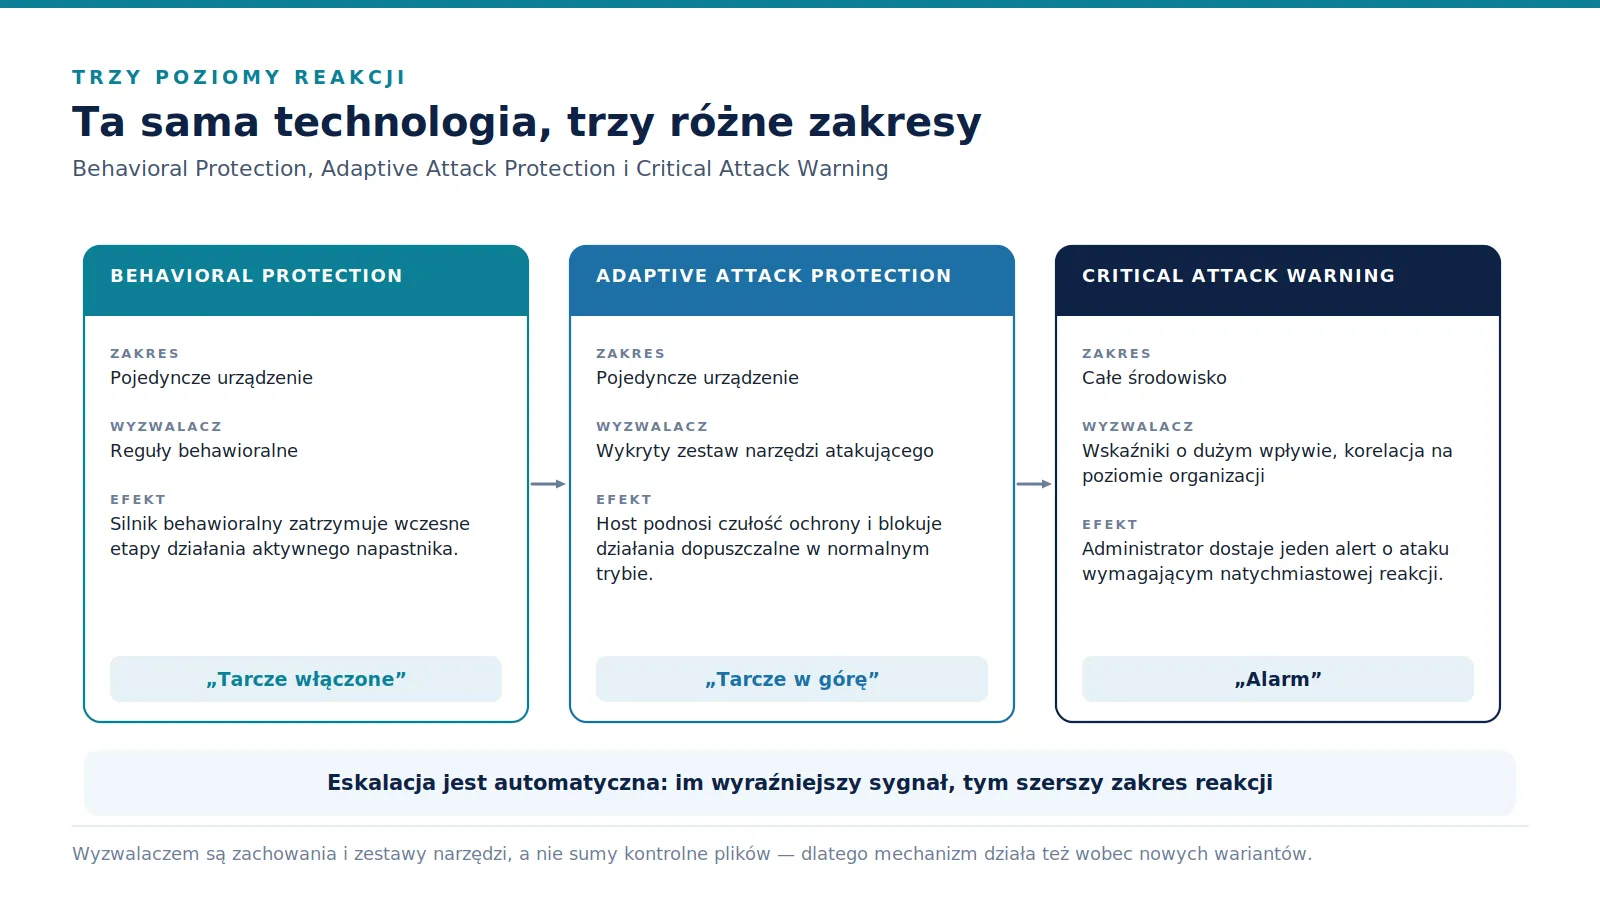
W Sophos Endpoint mechanizmy adaptacyjne układają się w trzy stopnie, które warto rozróżniać, bo odpowiadają na inne pytania.
Behavioral Protection — pojedyncze urządzenie, reguły behawioralne
Podstawowa warstwa: silnik behawioralny reagujący na sekwencje działań charakterystyczne dla wczesnych etapów aktywnego ataku. Działa stale, bez zmiany trybu, na każdym urządzeniu.
Adaptive Attack Protection — pojedyncze urządzenie, zmiana trybu
Tu dzieje się rzecz najciekawsza. Kiedy na hoście zostaną wykryte znane zestawy narzędzi atakującego albo kombinacja zachowań wskazująca na obecność operatora, urządzenie przechodzi w tryb podwyższonej ochrony.
Nie jest to alert ani rekomendacja. To zmiana obowiązującej polityki na tym konkretnym hoście: działania dopuszczalne w normalnej pracy — bo same w sobie nie są złośliwe — przestają być dozwolone, dopóki sytuacja się nie wyjaśni.
Critical Attack Warning — całe środowisko
Trzeci poziom działa ponad pojedynczym urządzeniem. Kiedy wskaźniki o dużym wpływie pojawiają się na wielu stacjach i serwerach naraz, korelacja na poziomie organizacji generuje jeden alert opisujący sytuację jako całość — zamiast pięćdziesięciu niezależnych zdarzeń, których powiązanie ktoś musiałby dopiero odkryć.
To rozróżnienie ma bezpośrednie przełożenie na proces: pierwszy poziom działa w tle, drugi zmienia warunki gry na hoście, trzeci jest sygnałem do uruchomienia procedury reagowania na incydent.
2. Co konkretnie zmienia tryb podwyższonej ochrony
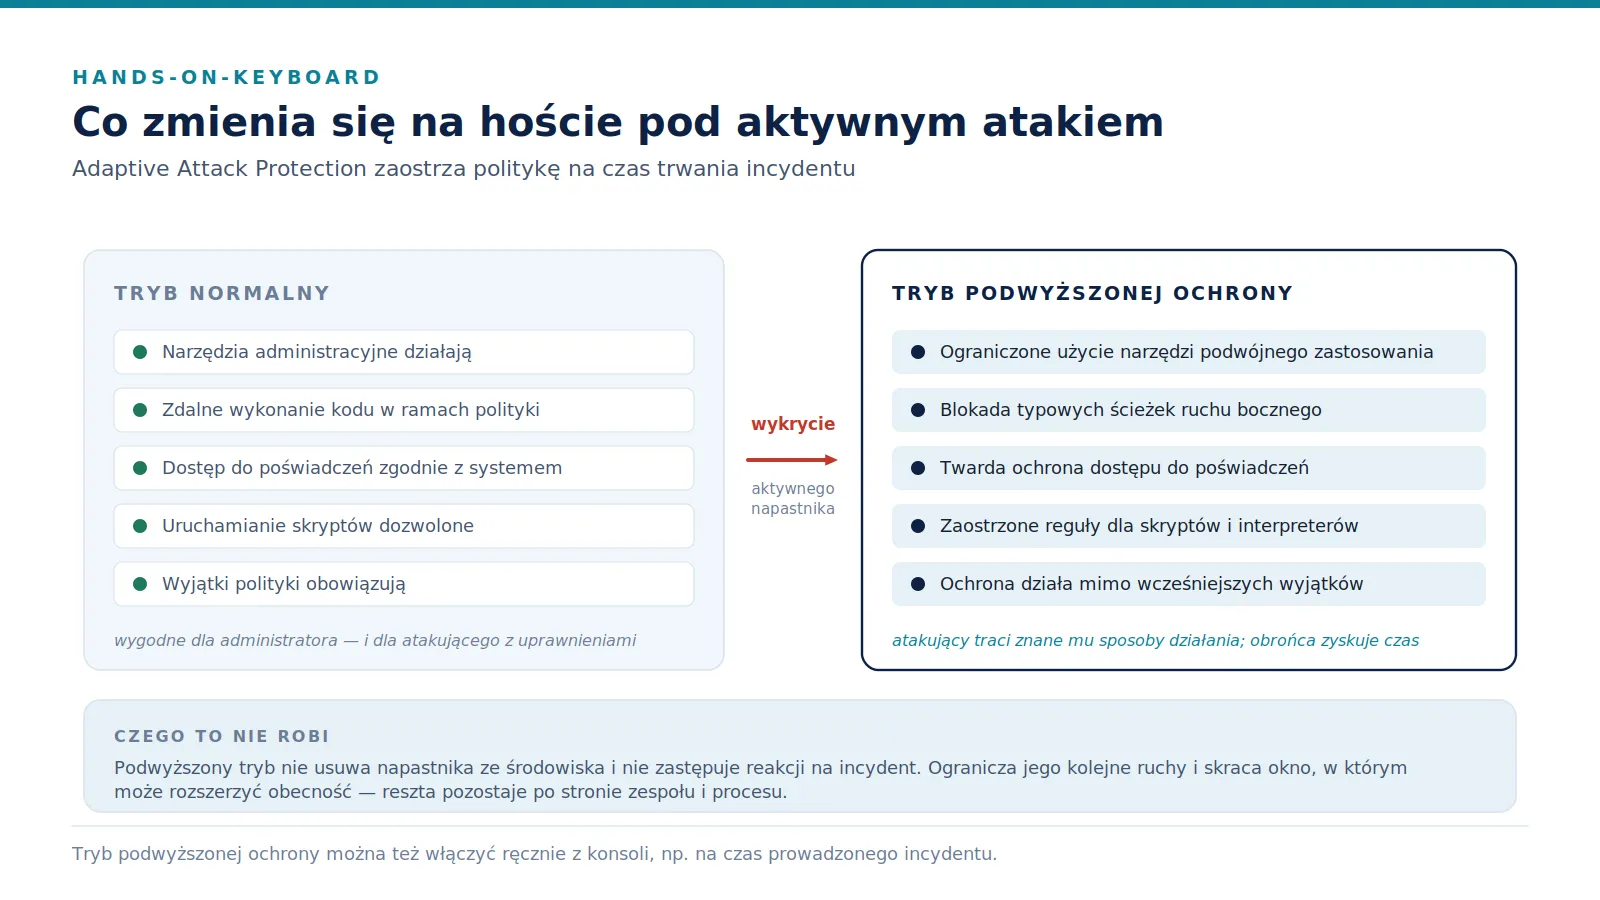
Mechanizm brzmi abstrakcyjnie, dopóki nie spojrzy się na to, co faktycznie przestaje działać. W trybie normalnym host jest skonfigurowany tak, żeby dało się na nim pracować: narzędzia administracyjne działają, skrypty się uruchamiają, wyjątki polityki obowiązują. Dokładnie te same właściwości są użyteczne dla kogoś, kto właśnie zdobył uprawnienia.
W trybie podwyższonym zmienia się kilka rzeczy naraz:
- ograniczone zostaje użycie narzędzi podwójnego zastosowania — legalnych, ale typowych dla fazy rozpoznania i eskalacji,
- blokowane są typowe ścieżki ruchu bocznego,
- zaostrza się ochrona dostępu do poświadczeń,
- zaostrzają się reguły dla interpreterów i skryptów,
- część wcześniej zdefiniowanych wyjątków przestaje obowiązywać.
Efekt jest asymetryczny i o to chodzi. Dla administratora oznacza to chwilową niewygodę. Dla kogoś, kto zbudował swój sposób działania na tym, że te operacje są dostępne, oznacza konieczność zmiany metody — i utratę czasu, którego zwykle nie ma w nadmiarze.
Warto dodać dwie rzeczy. Po pierwsze, tryb ten można włączyć również ręcznie z konsoli — na przykład na czas prowadzonego incydentu albo w okresie podwyższonego ryzyka. Po drugie, wyzwalacze są aktualizowane na podstawie badań producenta, więc mechanizm nie opiera się na statycznej liście.
Ten mechanizm nie usuwa napastnika ze środowiska i nie zastępuje reakcji na incydent. Ogranicza jego kolejne ruchy i skraca okno, w którym może rozszerzyć obecność. Reszta pozostaje po stronie zespołu i procesu.
3. Stan urządzenia jako kontekst dla sieci
Drugi wątek tej części dotyczy czegoś innego: co się dzieje, gdy informacja o stanie endpointu może opuścić endpoint.
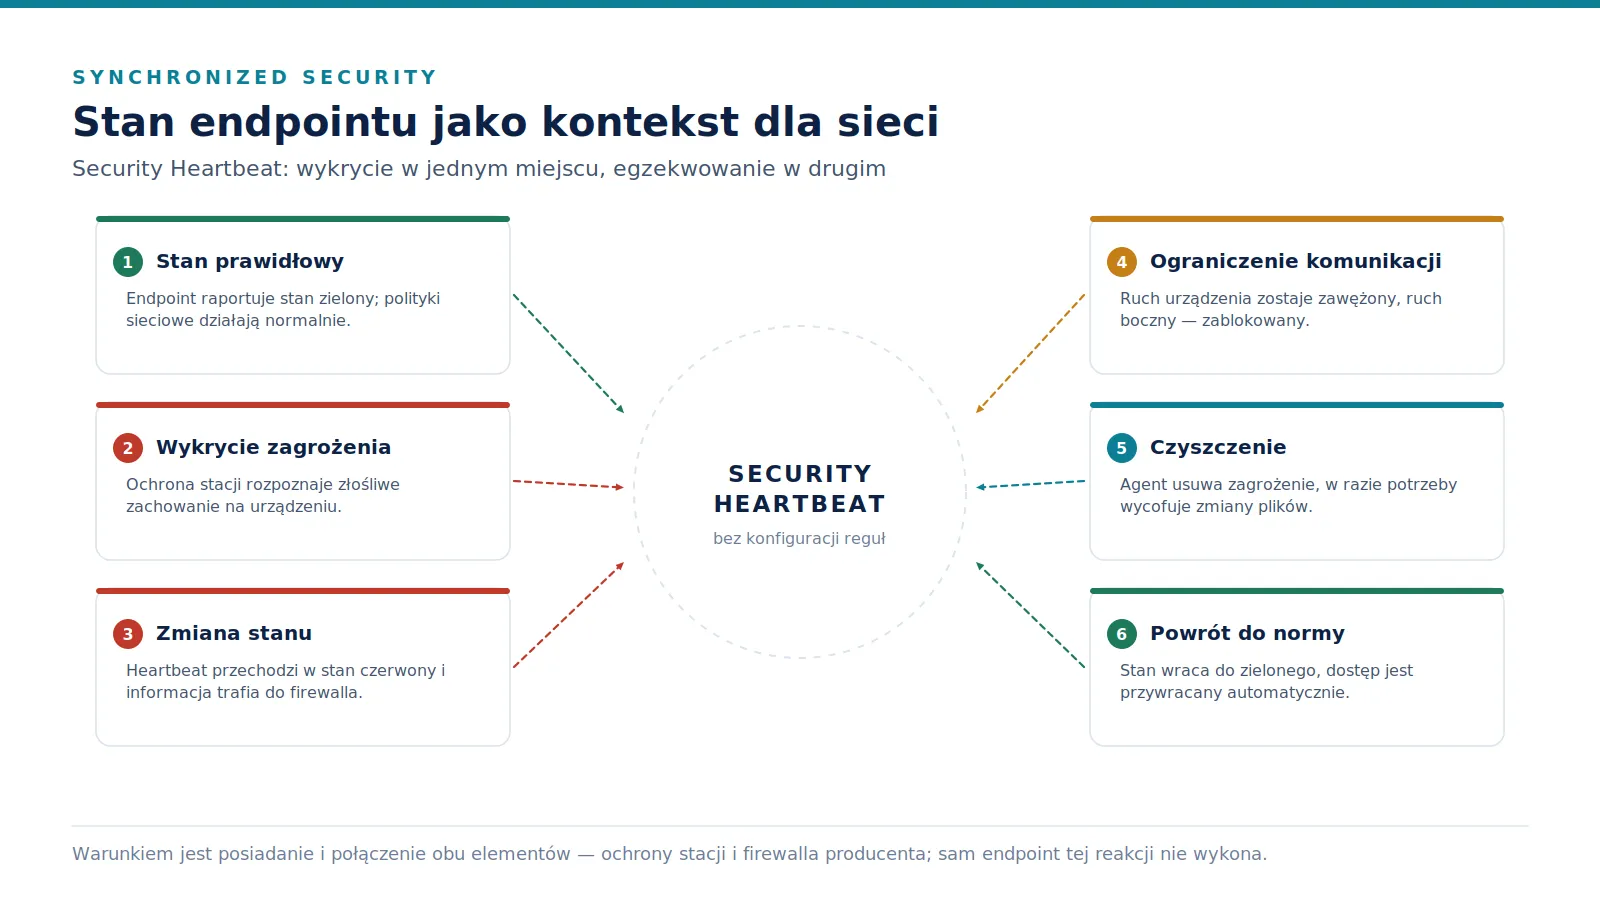
Security Heartbeat to mechanizm wymiany informacji o stanie bezpieczeństwa urządzenia z firewallem tego samego producenta. Endpoint regularnie raportuje swój stan; firewall może ten stan uwzględnić w regule.
Praktyczna konsekwencja jest taka, że polityka sieciowa przestaje brzmieć „ta sieć może rozmawiać z tamtą”, a zaczyna brzmieć „ta sieć może rozmawiać z tamtą, o ile stan urządzenia jest prawidłowy”. Gdy stan zmienia się na zagrożony, dostęp zawęża się automatycznie — bez ingerencji administratora i bez czekania na to, aż ktoś odbierze alert.
Pętla wygląda następująco:
- Endpoint raportuje stan prawidłowy, polityki działają normalnie.
- Ochrona stacji rozpoznaje złośliwe zachowanie na urządzeniu.
- Stan przechodzi na czerwony, informacja trafia do firewalla.
- Komunikacja urządzenia zostaje ograniczona, ruch boczny zablokowany.
- Agent usuwa zagrożenie i w razie potrzeby wycofuje zmiany plików.
- Stan wraca do zielonego, dostęp jest przywracany automatycznie.
Trzeba tu postawić wyraźne zastrzeżenie: to działa tylko wtedy, gdy w środowisku są oba elementy — ochrona stacji i firewall tego samego producenta, połączone w jednej konsoli. Sam endpoint takiej reakcji nie wykona. To argument za spójnością architektury, ale nie funkcja, którą dostaje się „w pakiecie” niezależnie od reszty infrastruktury.
Drugi kierunek: endpoint jako źródło kontekstu
Wymiana informacji nie jest jednostronna. Telemetria z endpointu zasila wspólne repozytorium danych, z którego korzysta warstwa detekcji i reakcji obejmująca inne elementy środowiska. Wykrycie w jednym punkcie kontrolnym podnosi poprzeczkę w pozostałych — i to jest właściwe uzasadnienie dla utrzymywania spójnego zestawu narzędzi, znacznie lepsze niż argument o jednej fakturze.
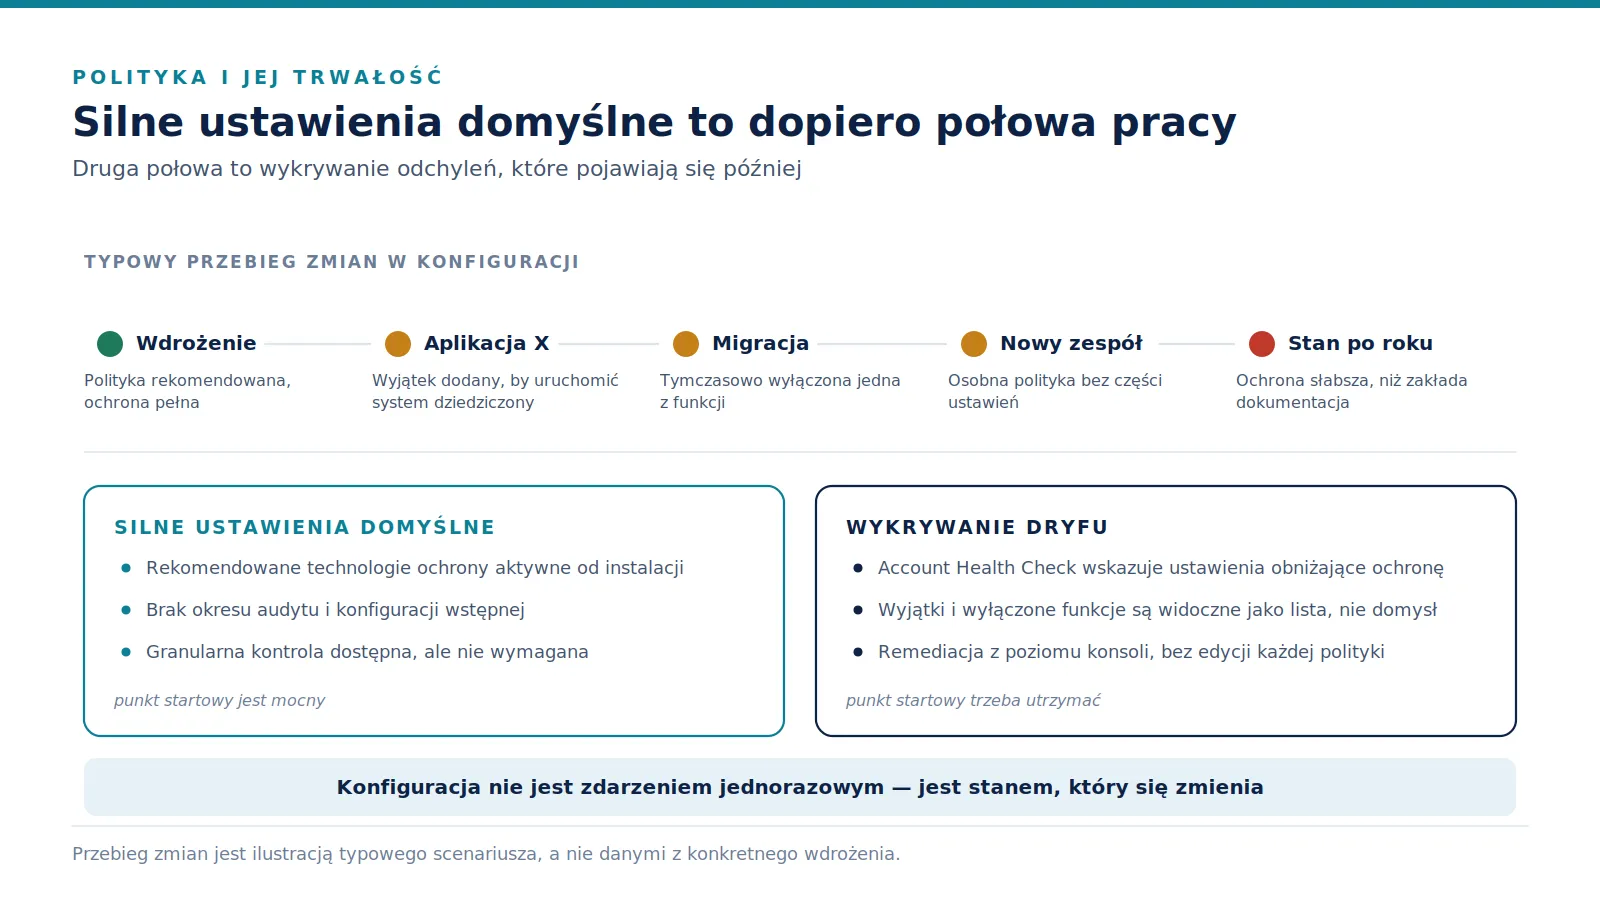
4. Silne ustawienia domyślne i ich trwałość
Wracam tu do wątku z pierwszej części, bo dopiero w kontekście reakcji adaptacyjnej widać jego pełne znaczenie.
Mechanizmy adaptacyjne operują na obowiązującej polityce. Jeśli polityka została osłabiona — bo dodano wyjątek dla systemu dziedziczonego, bo wyłączono funkcję na czas migracji, bo nowy zespół dostał osobną, uproszczoną konfigurację — to podwyższony tryb ochrony startuje z niższego poziomu.
Dryf konfiguracji nie jest zwykle skutkiem zaniedbania. Każda pojedyncza zmiana miała uzasadnienie w momencie wprowadzania. Problem polega na tym, że ich suma jest stanem, którego nikt świadomie nie zaprojektował.
Account Health Check adresuje dokładnie to: pokazuje odchylenia jako listę i pozwala je poprawić z poziomu konsoli. Warto ustawić sobie regularny przegląd tego zestawienia — kwartalnie w mniejszych środowiskach, częściej tam, gdzie zmian jest dużo.
5. Ile kosztuje tryb podwyższonej ochrony
Każdy mechanizm, który automatycznie zaostrza politykę, rodzi to samo pytanie: co się stanie, jeśli zadziała niepotrzebnie. Warto na nie odpowiedzieć, zanim zrobi to za nas użytkownik zgłaszający, że „coś przestało działać”.
Trzy obserwacje z praktyki.
Zakres skutku jest ograniczony. Tryb podwyższony obejmuje pojedynczy host, a nie całą organizację, i jest czasowy. Fałszywe zadziałanie nie zatrzymuje pracy firmy — zatrzymuje część operacji na jednej maszynie.
Ryzyko jest największe tam, gdzie administratorzy używają tych samych narzędzi co atakujący. Zdalne wykonanie poleceń, narzędzia do zrzutu pamięci, skrypty działające na wielu hostach naraz — to obszary, w których legalna praca administracyjna wygląda podobnie do rozpoznania. Jeśli w środowisku takie narzędzia są w codziennym użyciu, warto to przetestować w kontrolowanych warunkach przed pełnym wdrożeniem.
Mechanizm ma sterowanie. Dostępne są ustawienia dotyczące czasu trwania podwyższonej ochrony i zakresu reguł, a tryb można włączyć lub wyłączyć ręcznie. To nie jest przełącznik „włącz i módl się”, tylko element polityki — z tą różnicą, że domyślnie działa bez udziału człowieka.
Rekomendacja jest prosta: zostawić mechanizm włączony, a listę narzędzi administracyjnych używanych w środowisku sprawdzić świadomie, zamiast dowiadywać się o niej z pierwszego zgłoszenia.
6. Co z tego wynika dla procesu
Obrona adaptacyjna zmienia jedną rzecz w sposobie myślenia o reakcji: między wykryciem a pierwszym działaniem przestaje być człowiek. To nie znaczy, że człowiek przestaje być potrzebny — znaczy, że dostaje sytuację już częściowo ograniczoną, zamiast sytuacji w toku.
Trzy rzeczy, które warto z tego przenieść do własnego środowiska:
- Sprawdź, czy mechanizmy adaptacyjne są włączone i czy ktoś ich nie wyłączył podczas rozwiązywania problemu z kompatybilnością aplikacji.
- Ustal, kto reaguje na Critical Attack Warning i w jakim czasie. Alert o ataku obejmującym wiele urządzeń bez przypisanej odpowiedzialności jest tylko wpisem w konsoli.
- Zweryfikuj, czy wymiana stanu z firewallem jest faktycznie skonfigurowana, jeśli oba elementy są w środowisku. To funkcja, która bywa dostępna, ale nieużywana.
Źródła
- Sophos — Endpoint Protection (strona produktowa)
- Sophos — Synchronized Security
- Sophos Central — dokumentacja administratora
- Sophos Active Adversary Report — obserwacje z realnych incydentów
Podstawą merytoryczną są publiczne materiały produktowe Sophos (solution brief, solution brochure, buyer’s guide) oraz dokumentacja Sophos Central. Informacje zależne od wersji agenta, poziomu licencji i konfiguracji wymagają ponownej weryfikacji przed publikacją.